本页由繁体中文版自动转换
自动化等级
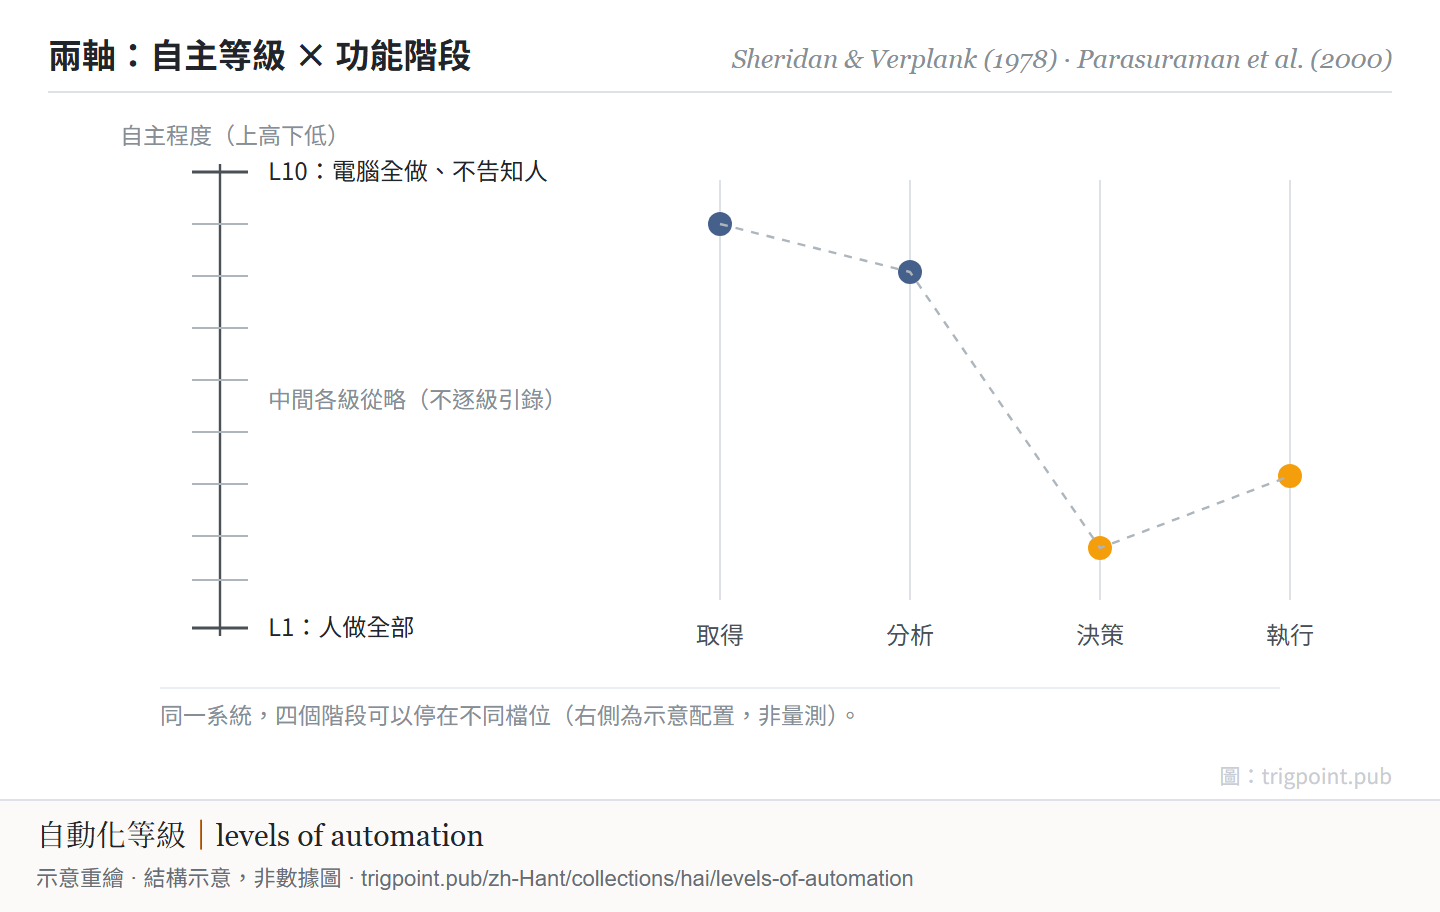
而且刻度要逐阶段分开拨:资讯取得、资讯分析、决策选择、动作执行,各自可以停在不同档位。
单一开关的想像,正是大多数自动化设计错误的起点。
中间各级文字从略:原报告表格位置未一手核对,不逐级引录原文。
右侧档位为示意配置,非量测。
两种点色分出两组:取得与分析拨到高档,决策与执行留在低档。 放大看图 ▸转发 PNG ▸
一、发生什么事
把自动化当成开关,会漏掉一件事:同一个系统的不同阶段,可以停在不同档位。1978 年,Sheridan 与 Verplank 在一份海底遥控作业研究报告中提出十级自主量表:第一级人做全部,第十级电脑全做且不告知人[1]Sheridan, T. B., & Verplank, W. L. (1978). Human and Computer Control of Undersea Teleoperators. MIT Man-Machine Systems Laboratory. 书目经官方记录核对。出处经跨模型双查核实。本页不逐级引录原文。。2000 年,Parasuraman、Sheridan 与 Wickens 补上第二条轴:自动化作用于四类资讯处理阶段(取得、分析、决策、执行),每一阶段可以独立选择等级[2]Parasuraman, R., Sheridan, T. B., & Wickens, C. D. (2000). A Model for Types and Levels of Human Interaction with Automation. IEEE Transactions on Systems, Man, and Cybernetics, Part A, 30(3), 286–297. 书目经官方记录核对。出处经跨模型双查核实。。代价面也有实证:Endsley 与 Kaber(1999)让 30 名受试者在动态控制任务中操作不同等级的自动化,发现绩效受益主要来自执行阶段的自动化,而且只限正常运作;人一旦被移出执行阶段,系统失效后的恢复表现就受损。人与电脑共同产生选项,绩效比单靠任何一方更差。决策阶段(在选项中做选择)的自动化则带来较低的负荷与较高的情境觉知,绩效只略有改善[3]Endsley, M. R., & Kaber, D. B. (1999). Level of automation effects on performance, situation awareness and workload in a dynamic control task. Ergonomics, 42(3), 462–492. 书目经官方记录核对。出处经跨模型双查核实。实验结果句依该文摘要。。所以「自动化到哪一级」是逐阶段的权衡设计,不是越高越好。
二、为什么这对你重要
给 AI agent 配权时,最有用的一个动作是把工作拆成四段再问:资讯搜集可以全自动吗?分析可以吗?决策呢?执行呢?多数场景的答案并不一致:搜集和分析可以拨到高档,决策和不可逆的执行留在低档。一刀切的「信任 AI」或「不信任 AI」,在这个框架下根本无从操作。
适用边界:往上拨是取舍。同一项实验中,执行阶段自动化在正常运作下提升绩效,却让失效后的恢复受损;人机共同产生选项也拉低绩效。十级刻度为 1978 年海底遥控作业而写,套用前先确认场景可比。
验证纪录
记录核查深度,不担保结论为真。
三个书目锚全部核实:Parasuraman、Sheridan 与 Wickens 2000(IEEE Trans SMC-A 30(3):286–297)[2]Parasuraman, R., Sheridan, T. B., & Wickens, C. D. (2000). A Model for Types and Levels of Human Interaction with Automation. IEEE Transactions on Systems, Man, and Cybernetics, Part A, 30(3), 286–297. 书目经官方记录核对。出处经跨模型双查核实。 与 Endsley、Kaber 1999(Ergonomics 42(3):462–492)[3]Endsley, M. R., & Kaber, D. B. (1999). Level of automation effects on performance, situation awareness and workload in a dynamic control task. Ergonomics, 42(3), 462–492. 书目经官方记录核对。出处经跨模型双查核实。实验结果句依该文摘要。 逐栏相符;十级量表确实出自 Sheridan 与 Verplank 1978 那份 MIT 报告,而非有时被引的 1980 或 1992,这点由 DTIC 编号、WorldCat 记录与历来的二手引用一致收敛而定[1]Sheridan, T. B., & Verplank, W. L. (1978). Human and Computer Control of Undersea Teleoperators. MIT Man-Machine Systems Laboratory. 书目经官方记录核对。出处经跨模型双查核实。本页不逐级引录原文。。此外,Endsley 与 Kaber 的实验结果依该文摘要撰写,全文未核。另有一项关于四阶段来历的核查结果:那条骨架不是 2000 年凭空发明,论文自述建在既有的人类资讯处理模型上;进一步查核同时更正了一项书目配对错误(Wickens 1984 的出版社与 ISBN 前缀在初查中被错配)。未核实一项:1978 报告内那张表的编号与页码未经一手核对,所以本页只依二手引用说它在该报告第八章,不写死表号[1]Sheridan, T. B., & Verplank, W. L. (1978). Human and Computer Control of Undersea Teleoperators. MIT Man-Machine Systems Laboratory. 书目经官方记录核对。出处经跨模型双查核实。本页不逐级引录原文。。
验证层·反例与失效边界
两个错位都出自把两条轴压成一条。其一,把自动化等级当成「一个系统一个档位」,逐阶段分配的解析度就没了,而那正是这个框架唯一的贡献。其二,把自主等级与功能阶段混为同一轴,等于退回开关式的二元思考,绕了一圈回到起点。失效边界另有两条。执行阶段自动化在正常运作下提升绩效,但把人移出执行阶段后,系统失效时的恢复表现受损;人与电脑共同产生选项,绩效也低于单靠任何一方[3]Endsley, M. R., & Kaber, D. B. (1999). Level of automation effects on performance, situation awareness and workload in a dynamic control task. Ergonomics, 42(3), 462–492. 书目经官方记录核对。出处经跨模型双查核实。实验结果句依该文摘要。。所以「往上拨」是要权衡的取舍,不是白捡的改良。而十级刻度本身是 1978 年为海底遥控作业写的,逐级文字未经一手核对,把它当通用档位表照抄之前,先确认你的场景与遥控作业有可比性。
Lab 实测 本理论在我们 studio 的两件实证
「建议,不执行」:自动步骤全部锁于决策层之下
工作室各自动化审核面共用一条红线:机器提出建议、清单与警示,状态翻转永远留给人。这不是不信任自动化,而是按阶段配权:资讯取得与分析拨至高档,决策与不可逆执行锁于低档。全文载红线的来历、哪些面曾试图越界、如何守住。
四阶段配权表:哪些阶段可以全自动,哪些不可以
把「取得/分析/决策/执行」四阶拆开,每个自动化面填一行档位,连理由一并写下。
如何阅读来源注记 「书目经…核对」指作者、年份、题名与出版项已确认;不代表该来源的主张已被核对。 定义版本:2026-09-20。
- [1] Sheridan, T. B., & Verplank, W. L. (1978). Human and Computer Control of Undersea Teleoperators. Cambridge, MA: MIT Man-Machine Systems Laboratory. https://doi.org/10.21236/ADA057655 ↩
- [2] Parasuraman, R., Sheridan, T. B., & Wickens, C. D. (2000). A Model for Types and Levels of Human Interaction with Automation. IEEE Transactions on Systems, Man, and Cybernetics, Part A, 30(3), 286–297. https://doi.org/10.1109/3468.844354 ↩
- [3] Endsley, M. R., & Kaber, D. B. (1999). Level of automation effects on performance, situation awareness and workload in a dynamic control task. Ergonomics, 42(3), 462–492. https://doi.org/10.1080/001401399185595 ↩