自動化等級
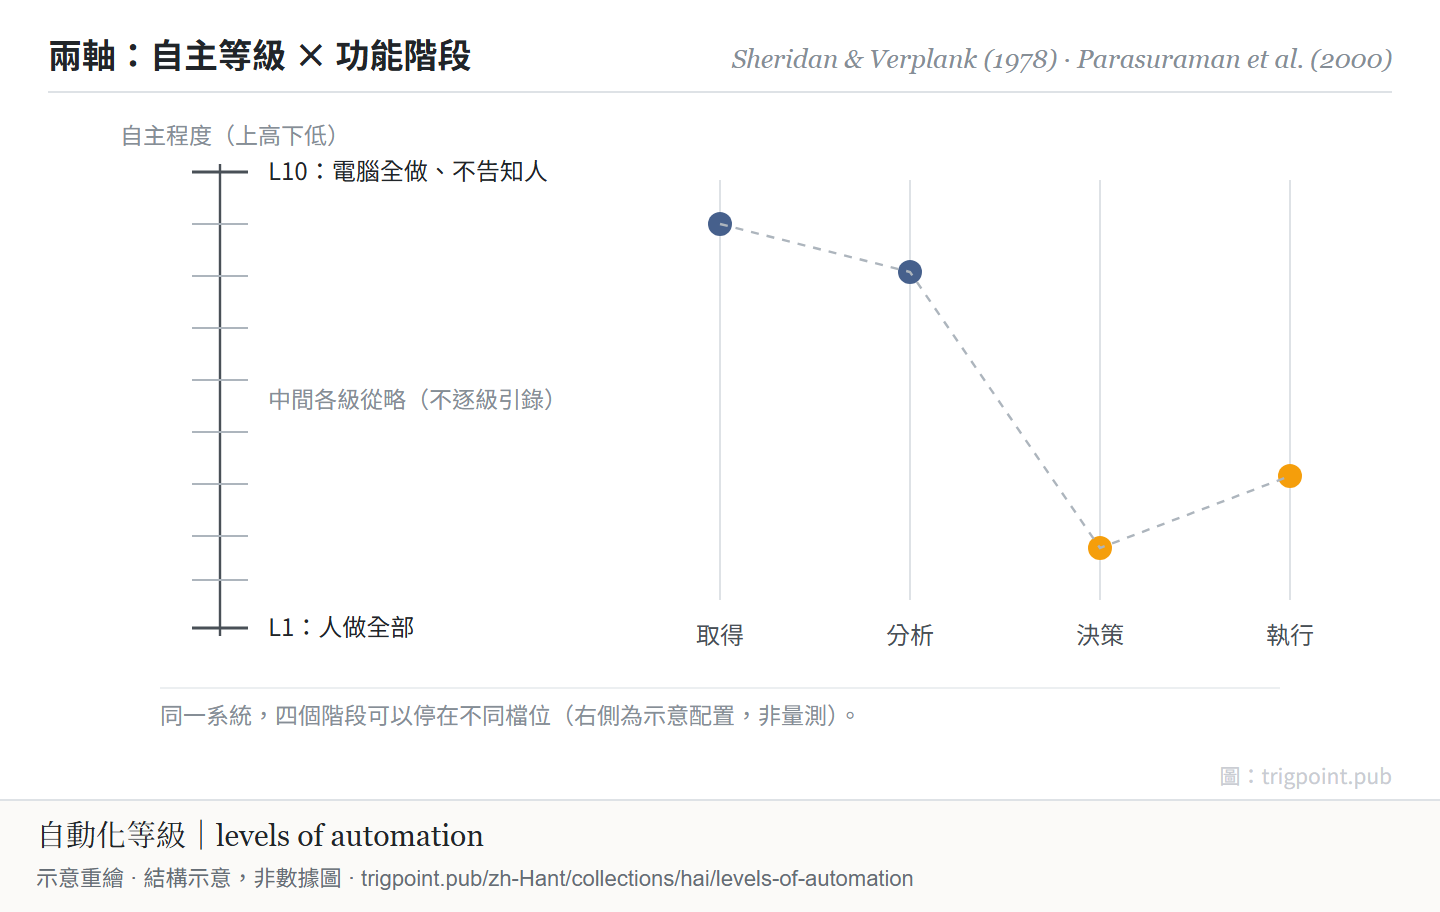
而且刻度要逐階段分開撥:資訊取得、資訊分析、決策選擇、動作執行,各自可以停在不同檔位。
單一開關的想像,正是大多數自動化設計錯誤的起點。
中間各級文字從略:原報告表格位置未一手核對,不逐級引錄原文。
右側檔位為示意配置,非量測。
兩種點色分出兩組:取得與分析撥到高檔,決策與執行留在低檔。 放大看圖 ▸轉發 PNG ▸
一、發生什麼事
把自動化當成開關,會漏掉一件事:同一個系統的不同階段,可以停在不同檔位。1978 年,Sheridan 與 Verplank 在一份海底遙控作業研究報告中提出十級自主量表:第一級人做全部,第十級電腦全做且不告知人[1]Sheridan, T. B., & Verplank, W. L. (1978). Human and Computer Control of Undersea Teleoperators. MIT Man-Machine Systems Laboratory. 書目經官方記錄核對。出處經跨模型雙查核實。本頁不逐級引錄原文。。2000 年,Parasuraman、Sheridan 與 Wickens 補上第二條軸:自動化作用於四類資訊處理階段(取得、分析、決策、執行),每一階段可以獨立選擇等級[2]Parasuraman, R., Sheridan, T. B., & Wickens, C. D. (2000). A Model for Types and Levels of Human Interaction with Automation. IEEE Transactions on Systems, Man, and Cybernetics, Part A, 30(3), 286–297. 書目經官方記錄核對。出處經跨模型雙查核實。。代價面也有實證:Endsley 與 Kaber(1999)讓 30 名受試者在動態控制任務中操作不同等級的自動化,發現績效受益主要來自執行階段的自動化,而且只限正常運作;人一旦被移出執行階段,系統失效後的恢復表現就受損。人與電腦共同產生選項,績效比單靠任何一方更差。決策階段(在選項中做選擇)的自動化則帶來較低的負荷與較高的情境覺知,績效只略有改善[3]Endsley, M. R., & Kaber, D. B. (1999). Level of automation effects on performance, situation awareness and workload in a dynamic control task. Ergonomics, 42(3), 462–492. 書目經官方記錄核對。出處經跨模型雙查核實。實驗結果句依該文摘要。。所以「自動化到哪一級」是逐階段的權衡設計,不是越高越好。
二、為什麼這對你重要
給 AI agent 配權時,最有用的一個動作是把工作拆成四段再問:資訊蒐集可以全自動嗎?分析可以嗎?決策呢?執行呢?多數場景的答案並不一致:蒐集和分析可以撥到高檔,決策和不可逆的執行留在低檔。一刀切的「信任 AI」或「不信任 AI」,在這個框架下根本無從操作。
適用邊界:往上撥是取捨。同一項實驗中,執行階段自動化在正常運作下提升績效,卻讓失效後的恢復受損;人機共同產生選項也拉低績效。十級刻度為 1978 年海底遙控作業而寫,套用前先確認場景可比。
驗證紀錄
記錄核查深度,不擔保結論為真。
三個書目錨全部核實:Parasuraman、Sheridan 與 Wickens 2000(IEEE Trans SMC-A 30(3):286–297)[2]Parasuraman, R., Sheridan, T. B., & Wickens, C. D. (2000). A Model for Types and Levels of Human Interaction with Automation. IEEE Transactions on Systems, Man, and Cybernetics, Part A, 30(3), 286–297. 書目經官方記錄核對。出處經跨模型雙查核實。 與 Endsley、Kaber 1999(Ergonomics 42(3):462–492)[3]Endsley, M. R., & Kaber, D. B. (1999). Level of automation effects on performance, situation awareness and workload in a dynamic control task. Ergonomics, 42(3), 462–492. 書目經官方記錄核對。出處經跨模型雙查核實。實驗結果句依該文摘要。 逐欄相符;十級量表確實出自 Sheridan 與 Verplank 1978 那份 MIT 報告,而非有時被引的 1980 或 1992,這點由 DTIC 編號、WorldCat 記錄與歷來的二手引用一致收斂而定[1]Sheridan, T. B., & Verplank, W. L. (1978). Human and Computer Control of Undersea Teleoperators. MIT Man-Machine Systems Laboratory. 書目經官方記錄核對。出處經跨模型雙查核實。本頁不逐級引錄原文。。此外,Endsley 與 Kaber 的實驗結果依該文摘要撰寫,全文未核。另有一項關於四階段來歷的核查結果:那條骨架不是 2000 年憑空發明,論文自述建在既有的人類資訊處理模型上;進一步查核同時更正了一項書目配對錯誤(Wickens 1984 的出版社與 ISBN 前綴在初查中被錯配)。未核實一項:1978 報告內那張表的編號與頁碼未經一手核對,所以本頁只依二手引用說它在該報告第八章,不寫死表號[1]Sheridan, T. B., & Verplank, W. L. (1978). Human and Computer Control of Undersea Teleoperators. MIT Man-Machine Systems Laboratory. 書目經官方記錄核對。出處經跨模型雙查核實。本頁不逐級引錄原文。。
驗證層·反例與失效邊界
兩個錯位都出自把兩條軸壓成一條。其一,把自動化等級當成「一個系統一個檔位」,逐階段分配的解析度就沒了,而那正是這個框架唯一的貢獻。其二,把自主等級與功能階段混為同一軸,等於退回開關式的二元思考,繞了一圈回到起點。失效邊界另有兩條。執行階段自動化在正常運作下提升績效,但把人移出執行階段後,系統失效時的恢復表現受損;人與電腦共同產生選項,績效也低於單靠任何一方[3]Endsley, M. R., & Kaber, D. B. (1999). Level of automation effects on performance, situation awareness and workload in a dynamic control task. Ergonomics, 42(3), 462–492. 書目經官方記錄核對。出處經跨模型雙查核實。實驗結果句依該文摘要。。所以「往上撥」是要權衡的取捨,不是白撿的改良。而十級刻度本身是 1978 年為海底遙控作業寫的,逐級文字未經一手核對,把它當通用檔位表照抄之前,先確認你的場景與遙控作業有可比性。
Lab 實測 本理論在我們 studio 的兩件實證
「建議,不執行」:自動步驟全部鎖於決策層之下
工作室各自動化審核面共用一條紅線:機器提出建議、清單與警示,狀態翻轉永遠留給人。這不是不信任自動化,而是按階段配權:資訊取得與分析撥至高檔,決策與不可逆執行鎖於低檔。全文載紅線的來歷、哪些面曾試圖越界、如何守住。
四階段配權表:哪些階段可以全自動,哪些不可以
把「取得/分析/決策/執行」四階拆開,每個自動化面填一行檔位,連理由一併寫下。
如何閱讀來源註記 「書目經…核對」指作者、年份、題名與出版項已確認;不代表該來源的主張已被核對。 定義版本:2026-09-20。
- [1] Sheridan, T. B., & Verplank, W. L. (1978). Human and Computer Control of Undersea Teleoperators. Cambridge, MA: MIT Man-Machine Systems Laboratory. https://doi.org/10.21236/ADA057655 ↩
- [2] Parasuraman, R., Sheridan, T. B., & Wickens, C. D. (2000). A Model for Types and Levels of Human Interaction with Automation. IEEE Transactions on Systems, Man, and Cybernetics, Part A, 30(3), 286–297. https://doi.org/10.1109/3468.844354 ↩
- [3] Endsley, M. R., & Kaber, D. B. (1999). Level of automation effects on performance, situation awareness and workload in a dynamic control task. Ergonomics, 42(3), 462–492. https://doi.org/10.1080/001401399185595 ↩