本页由繁体中文版自动转换
虚构引用
危险不在它看起来不可信,在它看起来完全可信。
格式可信度与内容真实性在此彻底脱钩,而唯一能拦住它的动作是回去查存在性。
- 成立条件
- 模型交来一份格式完整的书目或判例清单,你要决定能否照引时。
- 证据强度
- 实证结论;已对照来源本身
- 失效样貌
- 把它归入既有幻觉分类却不说明是外推;那组分类原为有明确来源的任务而设。
读者惯用的「格式即凭证」捷思在此失效,因为判断依据与判断对象互不蕴涵。
唯一的拦截点是回去查存在性。
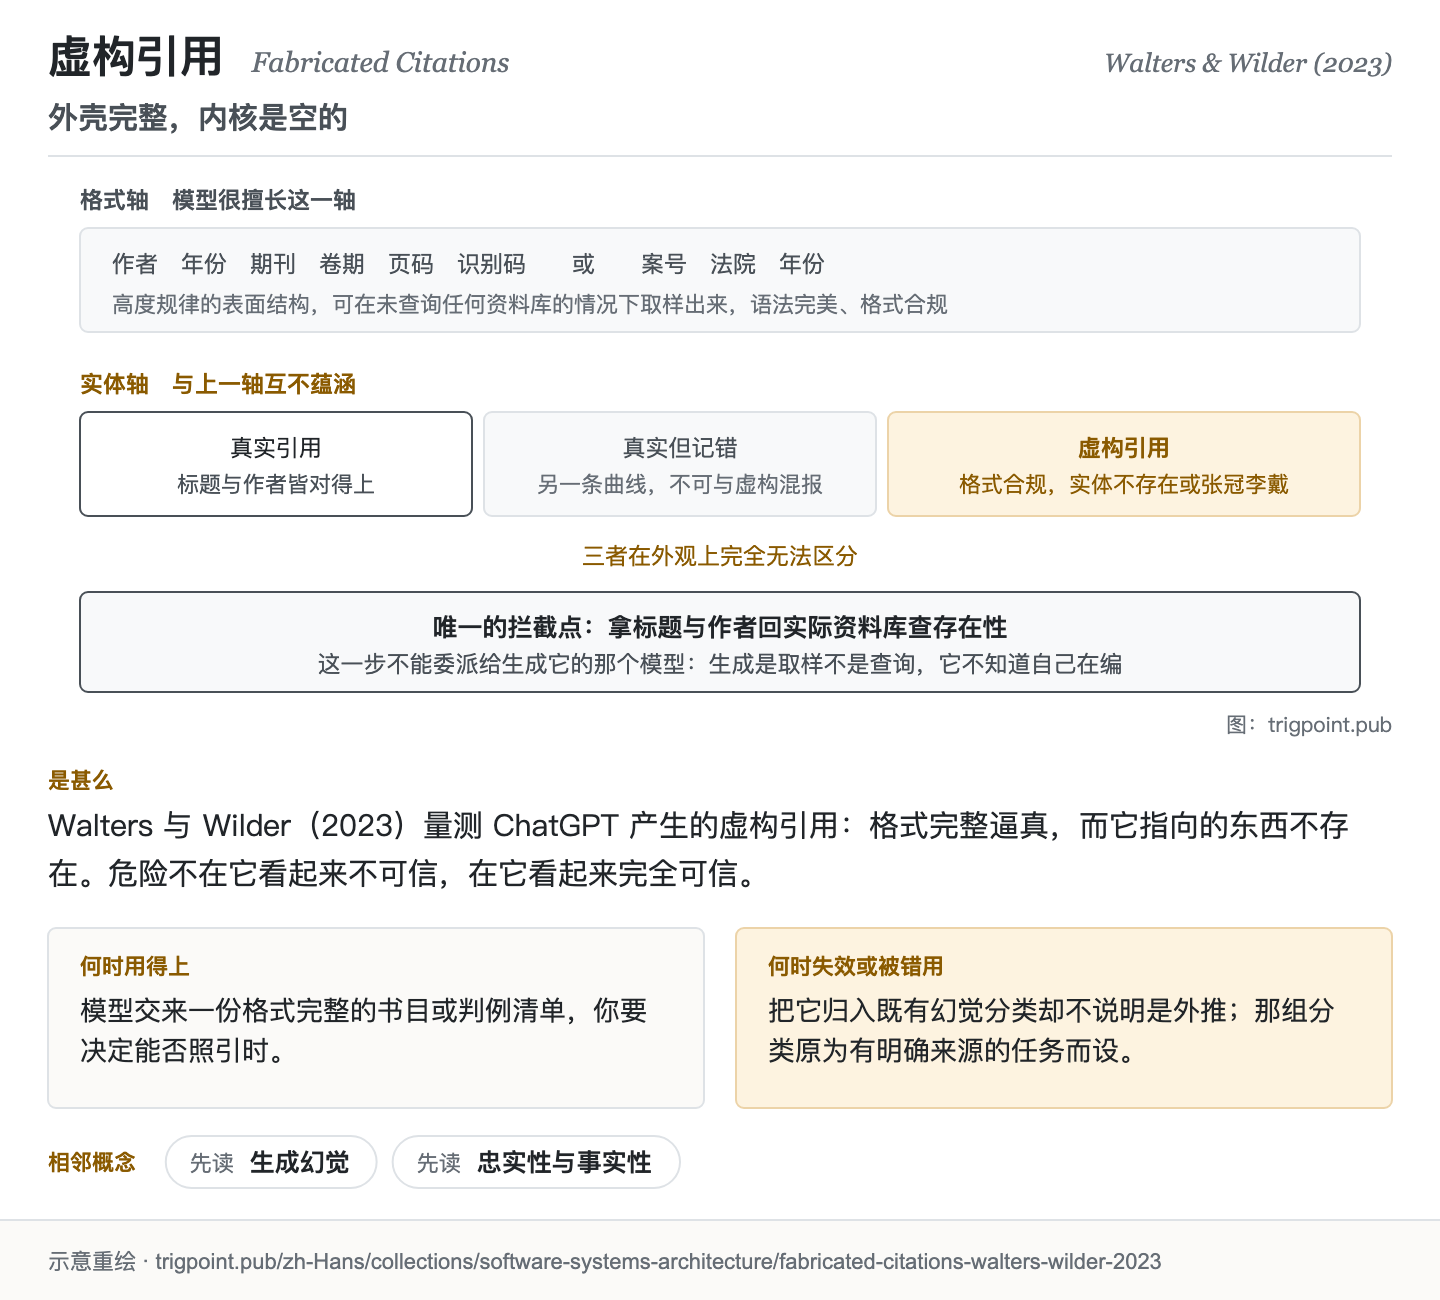
机制为概念示意,刻意不标任何虚构率:该类数字须绑定研究、模型版本与时点。 放大看图 ▸转发 PNG ▸
一、发生什么事
美国一起联邦地院案件里,律师把生成工具找来的判例写进书状,其中多件判例并不存在,法院最后处以罚款。书目与判例的格式是高度规律的表面结构:作者、年份、期刊、卷期、页码、识别码,或案号、法院、年份。生成模型对这种结构取样得极熟练:它可以在完全没有查询任何实际资料库的情况下,产出语法完美、格式合规的引用字串。
于是一件事发生了:读者与审查者惯用的「格式即凭证」捷思失效。因为判断依据(格式是否规范)与判断对象(那份东西是否存在)彼此独立、互不蕴涵。这不是一个程度问题,是两条轴完全脱钩。
Walters 与 Wilder 2023 年刊于《Scientific Reports》的研究把这件事量了出来,而它的方法定义值得逐字留着:若能找到一份在标题与作者两者上皆相符或近似相符的真实作品,即视该引用为真实[1]Walters, W. H., & Wilder, E. I. (2023-09-07). Fabrication and errors in the bibliographic citations generated by ChatGPT. Scientific Reports, 13, Article 14045. DOI 10.1038/s41598-023-41032-5. 书目经官方记录核对。主张已对照全文核实。方法定义:若能找到一份在标题与作者两者上皆相符或近似相符的真实作品,即视该引用为真实(非虚构)。。反面即为虚构。
它的数字很有名,而引用它必须连同条件一起带:在该研究的样本中(42 个跨学科主题、84 篇短文、636 条书目引用,量测时点为 2023 年),来自其中一个版本的引用有 55% 为虚构,来自较新版本的则为 18%[2]同篇之量测(引用时必须连同条件一起带):在该研究的样本中(42 个跨学科主题、84 篇短文、636 条书目引用,量测时点为 2023 年),来自其中一个版本的引用有 55% 为虚构,而来自较新版本的引用为 18%。两个数字皆绑定该研究、该两个模型版本与该时点,脱离条件即为过度概括。。两个数字都绑定那个研究、那两个模型版本与那个时点。脱离这些条件去讲「虚构率是多少」,本身就是一次过度概括。
它还做了一个容易被忽略的区分[3]同篇之另一项独立量测:真实引用之中仍有实质性引用错误;该比率只以真实引用为分母,与虚构率分开计算,不可混报。:虚构率与「真实引用之中的错误率」是两条独立曲线。一份真实存在的文献被记错年份或页码,跟一份不存在的文献被生成出来,不是同一件事,也不该合并报告。
司法场景有一个代价明确的实例:2023 年美国一起联邦地院案件,律师用生成工具查找判例,写进一份反对被告驳回起诉动议的书状,其中引用多件不存在的判例;法院认定其行为构成规则下之主观恶意并处连带罚款[4]司法场景实例:一起 2023 年美国联邦地院案件,律师用生成工具查找判例,写进一份反对被告驳回起诉动议的书状,其中引用多件不存在的判例;法院认定其行为构成联邦民事诉讼规则第 11 条下之主观恶意,对相关律师与律所处连带罚款。本站不列出那些虚构案名,判决书正文逐一列有。。本站不列出那些虚构案名,判决书正文逐一列有,要核对请回原文[5]案件细节:案号、罚款金额(5,000 美元)、判决日期与书状性质已对照判决书正文核对;判决报告之卷页引注依多个公开书目一致。。这个处置本身就是本页在讲的那件事:一笔引用在不在,回原文查。
二、为什么这对你重要
本页是本书架各页的收束点:一个系统的可信度,不能建立在它看起来对。
你会遇到的形态很具体。你请模型帮你找支持某个说法的文献,它回你五笔,格式整齐、有识别码、有页码。其中三笔真的存在,一笔存在但作者被换了,一笔完全不存在。而这五笔从外观上完全无法区分。
所以要做的事只有一件,而且没有替代方案:回去查存在性。 不是查格式对不对,是拿标题与作者去实际的资料库找那份东西在不在。这一步无法委派给生成它的那个模型,因为它的生成过程是取样不是查询:它不知道自己在编。
三个可以直接落成规矩的动作。
第一,把「有没有这份东西」与「这份东西有没有说这句话」分成两个独立的检查。 前者是存在性,后者是「忠实性与事实性」那条忠实轴。两者都可能单独失败。
第二,引用任何比率都绑条件。 哪个研究、哪个模型版本、哪个时间点。这条规矩看起来琐碎,但它挡掉的是一种典型的二次传播错误:一个 2023 年的数字被拿去描述今天。
第三,核到哪一层就说到哪一层。 这是本站的做法,也是本页在示范的:每一条来源都标明核到书目、摘要还是全文,没核到的不写成核过。标得低会让页面看起来「不够完整」,而那正是诚实的形状。
Lab 实测 有实测才写
本节点暂无实测。
- 常见转述「这是引用错误的一种」:不是。真实文献但年份或页码记错,与那份文献根本不存在,是两个范畴。原研究把两者分开量测,两条曲线不可混报。 #
- 常见转述「模型在说谎」:无意图可言。这是取样机制的结构性副作用,模型不知道自己在编。把它框成故意欺骗是拟人化误读,也会让人去修错的东西。 #
- 常见转述「某个研究说虚构率是 X」:虚构率随模型与版本剧烈变动。引用任何数字都必须绑定哪个研究、哪个模型版本、哪个时间点,否则构成脱离情境的过度概括。 #
记录核查深度,不担保结论为真。
修正记录- 2026-10-25 · 本页开架前更正两处,皆已对照判决书正文。其一,前版说律师以生成工具撰写的是一份动议;实为反对被告驳回起诉动议的书状。其二,前版说虚构案名只见于搜寻摘要、法院原文全文未能取得,案件细节因此标为次级;判决书正文已对读,案名在其中逐一列明,本页仍不列出。
如何阅读来源注记 「书目经…核对」指作者、年份、题名与出版项已确认;不代表该来源的主张已被核对。「对照全文核实」指主张已与来源文本本身比对。 定义版本:2026-09-20。
- [1] Walters, W. H., & Wilder, E. I. (2023). Fabrication and errors in the bibliographic citations generated by ChatGPT. Scientific Reports, 13, 14045. DOI 10.1038/s41598-023-41032-5. ↩
- [2] Walters, W. H., & Wilder, E. I. (2023). Fabrication and errors in the bibliographic citations generated by ChatGPT. Scientific Reports, 13, 14045. DOI 10.1038/s41598-023-41032-5.
- [3] Walters, W. H., & Wilder, E. I. (2023). Fabrication and errors in the bibliographic citations generated by ChatGPT. Scientific Reports, 13, 14045. DOI 10.1038/s41598-023-41032-5.
- [4] Mata v. Avianca, Inc., 678 F. Supp. 3d 443 (S.D.N.Y. 2023), No. 1:22-cv-01461 (PKC), Opinion and Order on Sanctions (22 June 2023). 书目经多源交叉核对。主张已对照全文核实。
- [5] Mata v. Avianca, Inc., 678 F. Supp. 3d 443 (S.D.N.Y. 2023), No. 1:22-cv-01461 (PKC), Opinion and Order on Sanctions (22 June 2023).
新书架开架时通知我
开架通知只在新书架开架或阅读规则变更时寄出。