本页由繁体中文版自动转换
生成幻觉
危险不在错,在错得流畅:流畅度给了真值不具备的可信外观。
而它的成因跨资料、训练、解码三层,目前只能收窄,不能假设已经归零。
- 成立条件
- 要查核模型输出,而手上有明确的来源可对照时。
- 证据强度
- 概念框架;摘要已核
- 失效样貌
- 没有明确来源的开放式生成,两型只能外推;忠于来源也未必合于事实。
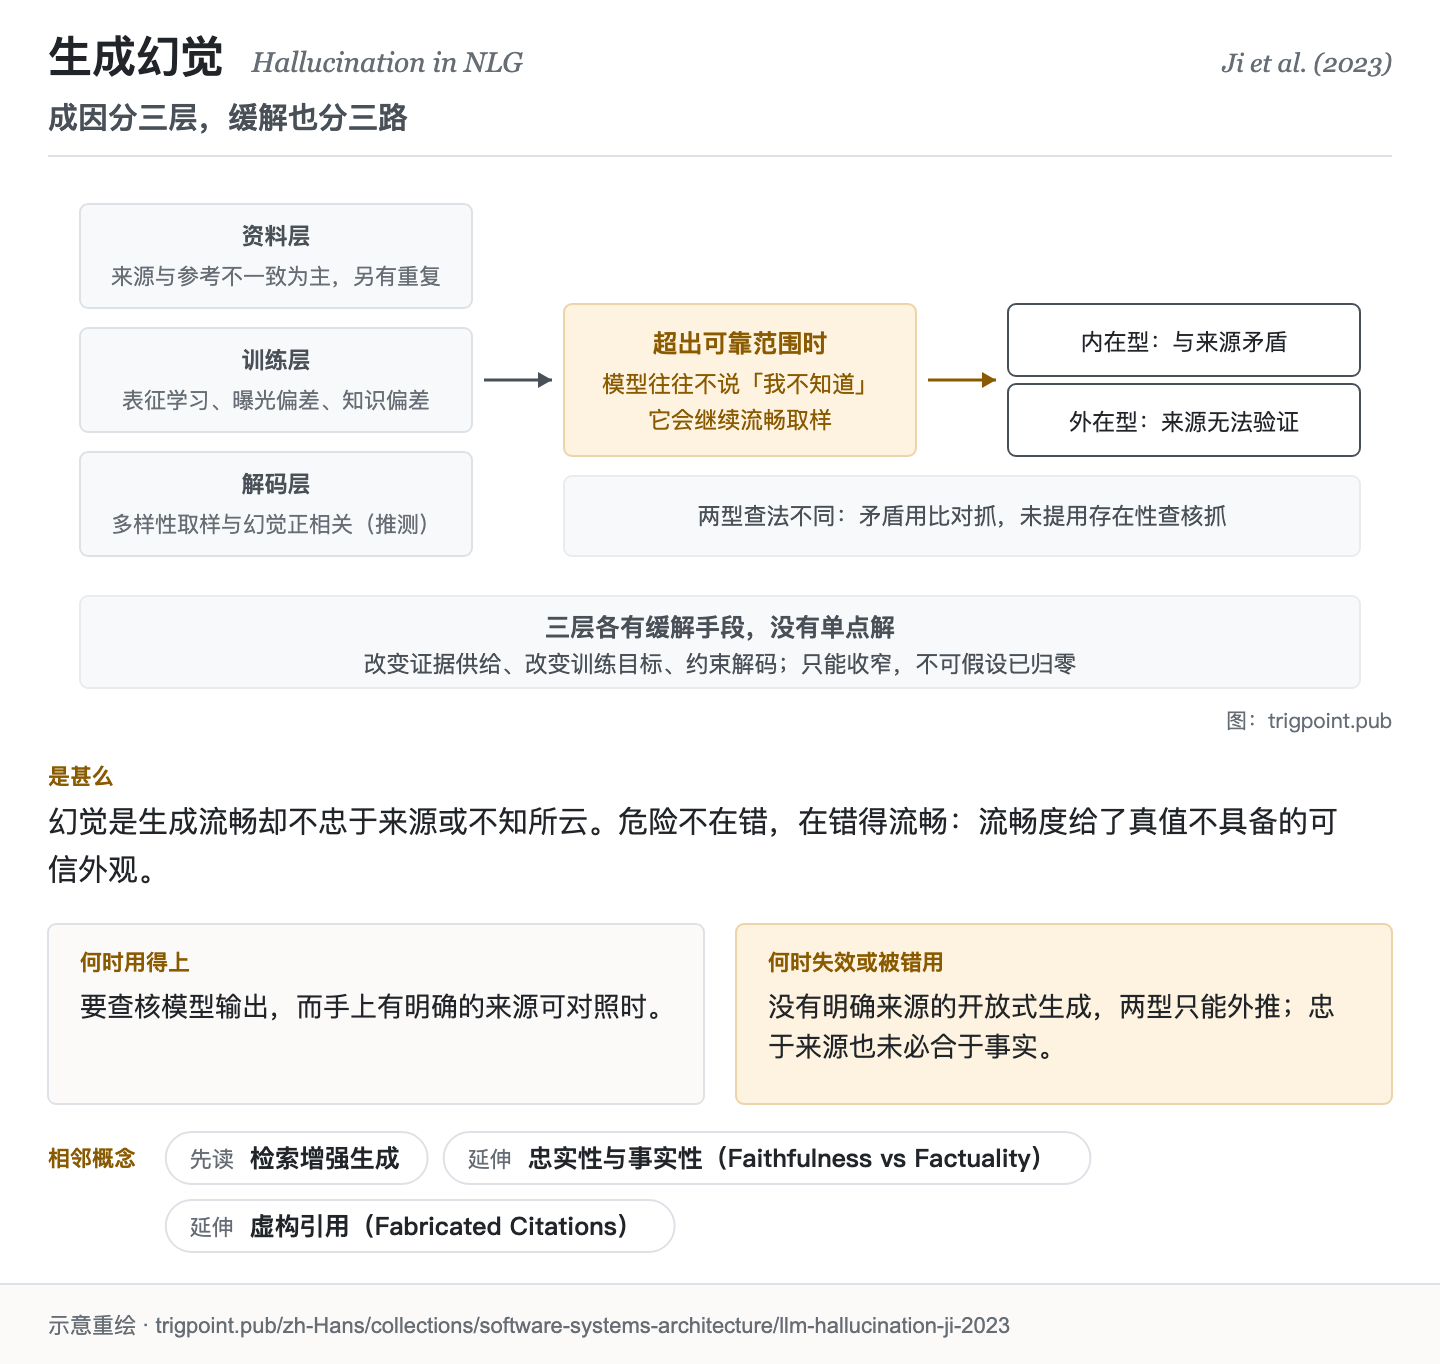
三层各有各的缓解手段,没有单点解,也没有一层宣称能归零。
三层成因汇向中段,即这页最反直觉的一点:超出可靠范围时,模型往往不说「我不知道」,而是继续流畅地取样;这个倾向与现行训练和评分方式奖励猜测有关。
这样生成的幻觉分两型,标在右侧:内在型是与来源矛盾,外在型是无法从来源验证。
机制为概念示意,刻意不标任何幻觉率或比例。 放大看图 ▸转发 PNG ▸
一、发生什么事
Ji 等人 2023 年刊于《ACM Computing Surveys》的综述,采用的定义是:生成的内容不知所云,或不忠于所提供的来源内容[1]Ji, Z., Lee, N., Frieske, R., Yu, T., Su, D., Xu, Y., Ishii, E., Bang, Y. J., Madotto, A., & Fung, P. (2023). Survey of Hallucination in Natural Language Generation. ACM Computing Surveys, 55(12), Article 248. DOI 10.1145/3571730. 书目经官方记录核对。主张已对照全文核实。期刊版共 10 位作者;预印本 arXiv:2202.03629 第一版 2022-02-08,其后版本增列作者,2024 年 7 月版为 13 位。该综述 §2 采用的定义引自先前研究:生成的内容不知所云,或不忠于所提供的来源内容。。分类分两型:内在型是与来源矛盾,外在型是无法从来源验证[2]分类定义(该篇 §2.1):内在型为与来源内容矛盾之输出;外在型为无法从来源内容验证之输出。。
机制值得慢慢看,因为它决定了你能做什么。生成模型本质是对训练分布的压缩,解码时逐个记号取样。当任务需要的资讯超出模型可靠压缩的范围(分布外、长尾、或训练之后世界变了),模型往往不会停下来说「我不知道」:它会继续流畅地取样。这就是幻觉。这个倾向有一部分是被奖励出来的:一篇 2025 年的研究主张,现行训练与评分方式给猜测分数、不给承认不确定的分数,模型因此在没把握时倾向照猜[6]Kalai, A. T., Nachum, O., Vempala, S. S., & Zhang, E. (2025). Why Language Models Hallucinate. arXiv:2509.04664. 书目经官方记录核对。要旨与摘要一致。摘要原意:模型在没把握时有时会猜,而非承认不确定;作者主张成因是训练与评估程序奖励猜测多于承认不确定。。所以它不是不能说不知道,而是在现行奖励下少说。
Ji 等人的综述把成因分成两大类:资料,以及训练与推论。本页把后者再拆成训练与解码,合起来看三层,这也是为什么没有单点解:资料层(主因是来源与参考答案本身就不一致;资料收集时未滤除的重复是另一种情形)、训练层(表征学习不良、训练与生成之间的曝光偏差、模型偏向预训练时带来的知识而非手上的来源)、解码层(多样性取样与幻觉正相关,但其机制原文标为推测)。缓解也可对应分三路:改变证据供给(检索增强,见「检索增强生成」)、改变目标(用忠实度的度量去训)、改变解码(约束生成)。
二、为什么这对你重要
这页给你的不是警告,是一个校准值:你该对流畅度打多少折。
人判断可信度时,语言的流畅与结构的整齐是强力线索:这在人写的东西上大致有效,因为胡说的人通常也讲得比较乱。生成模型把这个相关性切断了:它的流畅度与内容真假几乎无关。所以你的直觉在这里不是不准,是被校准在错的分布上。
第二件事是「少说不知道」这个倾向的实务后果。你不能靠模型主动示警来抓幻觉:它在没把握时往往照猜,猜错时讲得一样流畅。这意味着查核的责任在你这一侧,而且必须是流程而不是警觉:警觉会疲劳,流程不会。
第三件事,也是本书架的立场所在:既然没有任何一层能保证它已经归零,模型又不会可靠地示警,那么「值得信任的输出」就不能靠模型的品质保证,只能靠可查核性。
实务上两个动作就够了。第一,把「这句话的依据在哪」变成固定问句,而不是凭感觉挑句子查。第二,分开处理两型:与你给的来源矛盾(内在型)用比对抓;来源根本没提(外在型)用存在性查核抓。两者的查法不同,混在一起会两边都漏。所以开始查核之前,先问一句:我手上有没有一份可以拿来对照的来源。
Lab 实测 有实测才写
本节点暂无实测。
- 常见转述「内在型与外在型这组分类是 Ji 等人的综述提出的」:该篇第 2.1 节自己写明是沿用先前研究的分类。本站把它当作整理整个领域的锚;它不是分类的原创者。该综述 §2 采用的幻觉定义,同样引自先前研究。 #
- 常见转述「新版模型已经不会幻觉了」:Ji 等人的综述列的是成因与分型缓解,没有任何一层宣称可以归零。本站因此把它当作只能收窄、不可假设已归零的常态风险;这是本站的设计前提,不是该综述的结论。这句话不是悲观,是决定你要不要建查核流程的前提。 #
- 常见转述「这个词是大型语言模型时代才有的」:更早的已验用例,例见 2018 年一篇视觉语言任务的论文;该综述自己也记此词最先出现在 2000 年的电脑视觉研究,当时含意偏正面。 #
记录核查深度,不担保结论为真。
修正记录- 2026-10-12 · 本页前版有三处超出 Ji 等人 2023 年综述的原文,已依全文改正。其一,前版把「幻觉源自压缩加取样的结构,只能收窄不能归零」写成源头的结论;综述只列成因与分型缓解,没有主张它不可消除。本书架的立场句保留,但前提改为「没有任何一层能保证已归零、模型又不会可靠示警」,并标明是本书架自己的立场。其二,前版把训练层成因写成「最大化似然的目标奖励流畅、不奖励忠实」;综述列的是表征学习不良、曝光偏差与参数知识偏差,资料层主因是来源与参考答案不一致。其三,前版说忠于来源与合于事实「不是同一件事」;综述原文是两者可能相同也可能不同。
如何阅读来源注记 「书目经…核对」指作者、年份、题名与出版项已确认;不代表该来源的主张已被核对。「与摘要一致」指主张与论文摘要相符;不含逐句对照全文。「对照全文核实」指主张已与来源文本本身比对。 定义版本:2026-09-20。
- [1] Ji, Z. et al. (2023). Survey of Hallucination in Natural Language Generation. ACM Computing Surveys, 55(12), Article 248. DOI 10.1145/3571730.
- [2] Ji, Z. et al. (2023). Survey of Hallucination in Natural Language Generation. ACM Computing Surveys, 55(12), Article 248. DOI 10.1145/3571730.
- [6] Kalai, A. T., Nachum, O., Vempala, S. S., & Zhang, E. (2025). Why Language Models Hallucinate. arXiv:2509.04664. https://arxiv.org/abs/2509.04664 ↩
新书架开架时通知我
开架通知只在新书架开架或阅读规则变更时寄出。