本页由繁体中文版自动转换
命令查询职责分离
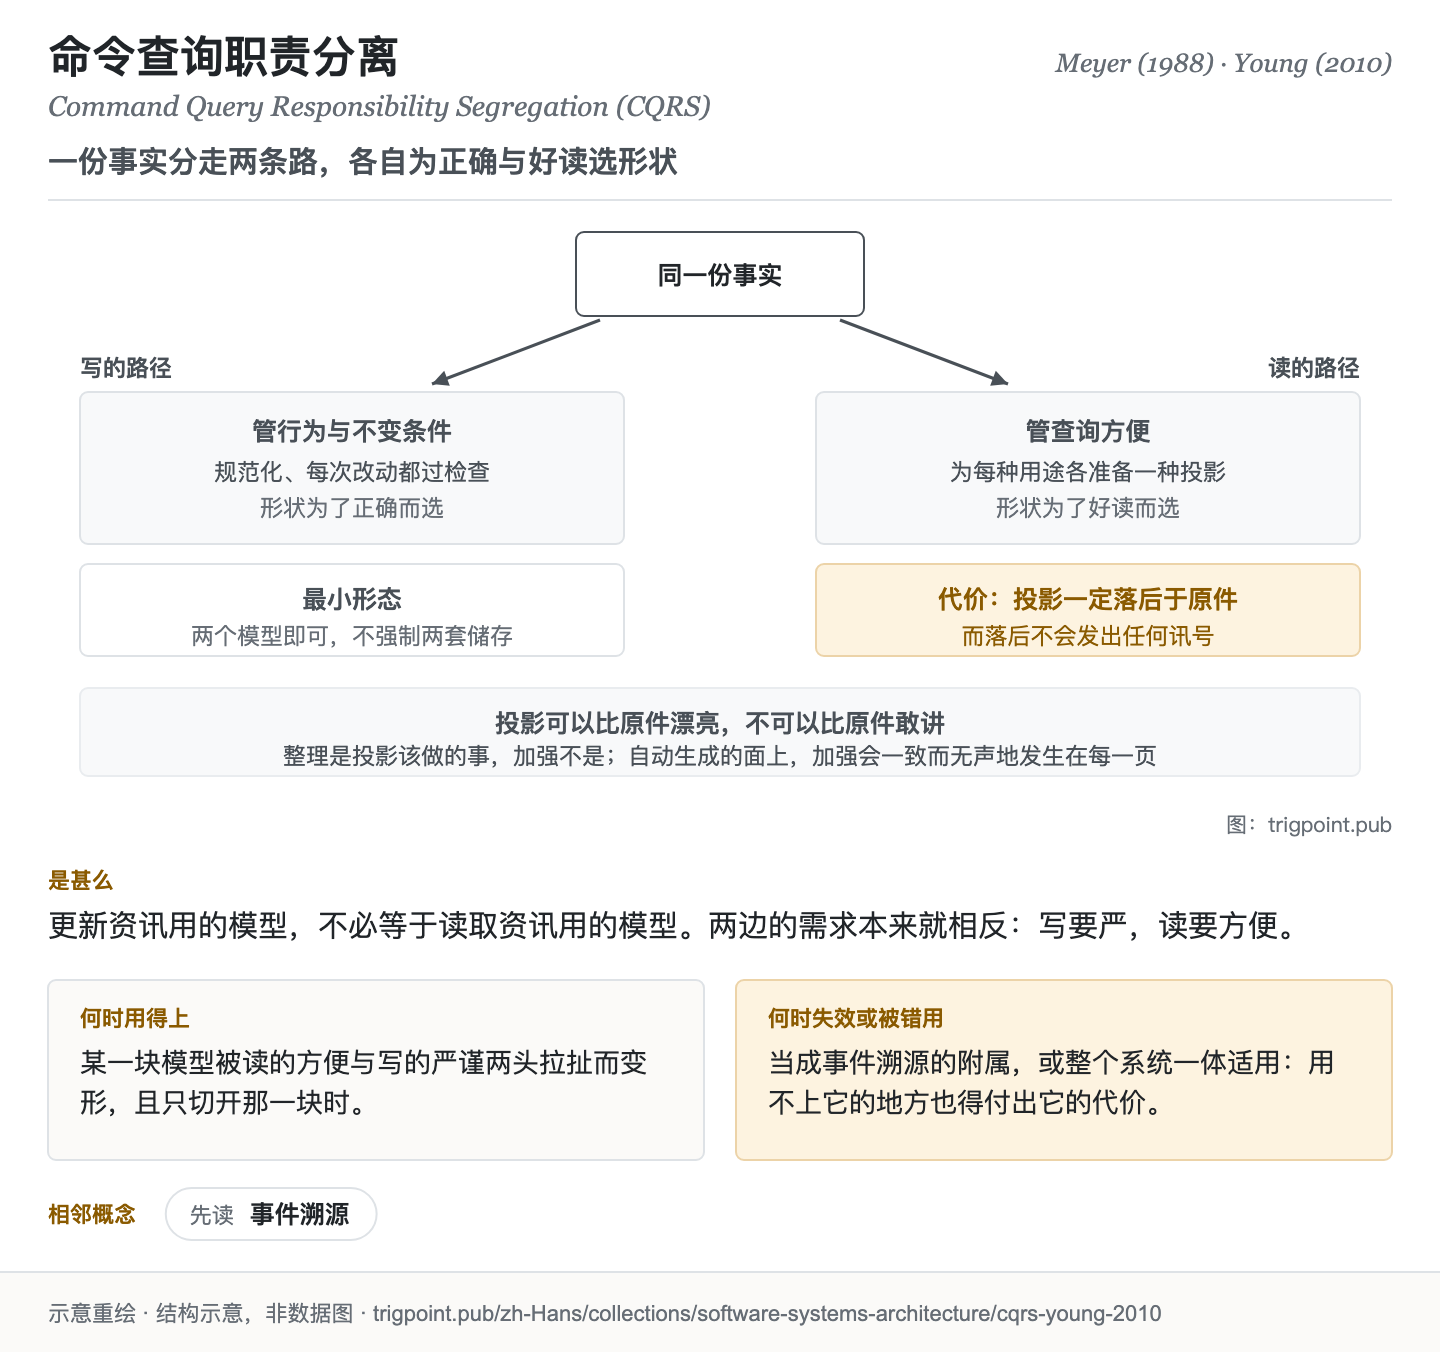
两边的需求本来就相反:写要严,读要方便。
分开之后多出一个东西要顾,就是那份会落后于原件的投影。
- 成立条件
- 某一块模型被读的方便与写的严谨两头拉扯而变形,且只切开那一块时。
- 证据强度
- 概念框架;书目已核
- 失效样貌
- 当成事件溯源的附属,或整个系统一体适用:用不上它的地方也得付出它的代价。
两边各自可以有自己的形状。
底部标出一条纪律:投影可以比原件漂亮,不可以比原件敢讲。
流程为概念示意,不含延迟、笔数或任何量测数字。 放大看图 ▸转发 PNG ▸
一、发生什么事
读与写该共用一份模型,还是各用一份,是一个要逐块判断的取舍。一份模型同时服务读与写时,它得同时满足两组互相拉扯的要求。写的那一边要严:资料要规范化、不变条件要守得住、每次改动都得通过检查。读的那一边要方便:常常需要跨好几处拼起来的视图、需要为不同用途各准备一种形状、需要快。
模型被两边同时拉的结果是扭曲:为了读方便而放宽结构,或为了写严谨而让每个查询都要绕远路。这个模式的主张很单纯:沿读与写的边界,把一个模型切成两个[2]Young, G. (2010-11). CQRS Documents (PDF). 书目经官方记录核对。主张已对照全文核实。作者自行发布、把这个模式系统化整理的实务文件。文中自述:它起初只被当成在更高层次套用命令查询分离,经过一段混淆之后才被认定为另一个模式。。写的那一边专注行为与一致性,读的那一边专注查询优化的投影。
它的祖系是 Meyer 1988 年《Object-Oriented Software Construction》里的「命令与查询分离」:一个方法要嘛改状态而不回值,要嘛回值而无副作用[1]Meyer, B. (1988). Object-Oriented Software Construction (1st ed.). Prentice Hall. 书目经双源核对。命令与查询分离及其用词之归属依多源一致转述。命令与查询分离之原典:一个方法要嘛改状态而不回值,要嘛回值而无副作用;命令与查询这组词汇的来源。书内章节本页未逐字核对。。那条规矩管的是方法层,这个模式把同一个切法升到模型层。
这个切法也有施用范围。2011 年的一篇文章特别强调:这个模式应该局部施用在确实被读写冲突扭曲的那一块,不是整个系统统一架构[3]Fowler, M. (2011-07-14). CQRS. martinfowler.com/bliki/CQRS.html. 书目经官方记录核对。主张已对照全文核实。原句说这个模式是作者最先从 Young 口中听到的描述;同文主张它只应施用在系统的特定部分,而非整个系统。。
二、为什么这对你重要
你已经在用这个模式了,只是没有把它的纪律一起带进来。
任何「派生出来给人看的东西」都是读模型:一份月报、一张看板、一页对外说明、一段喂给模型的摘要。它们的原件在别处。你之所以做它们,正是因为原件的形状不适合那个用途:这就是分离的理由,而且理由是对的。
分离带来的成本只有一项,但它是结构性的:投影一定会落后于原件。 落后多少取决于你多久重新生成一次,而落后这件事本身不会发出任何讯号。一份三周前生成的看板,看起来跟今天生成的一模一样。
所以这页给的实务是三条,第三条最少人做。
第一,决定要不要分之前先问:读的人跟写的人是同一群吗。 如果是同一个人(例如你自己的决策记录),分离大概只是多一份要维护的东西。如果不是(对外页面、交给协作者的说明、喂给模型的脉络),分离几乎总是对的。
第二,投影一律标生成时间。 这是承认落后,而不是假装同步。
第三,也是本页真正要留下的一句:投影可以比原件漂亮,不可以比原件敢讲。 派生的过程很容易加料:把一个模糊的等级换成一句明确的措辞、把一段有保留的叙述整理成一句干净的结论。整理是投影该做的事,加强不是。而这种加强在自动生成的面上特别危险,因为它会一致地、无声地发生在每一页上。
Lab 实测 本理论在我们工作室的两次实测
投影可以比原件漂亮,不可以比原件敢讲
情境:我们的对外知识页照读写分离建置:写的一边是逐节点的内容资料档,管事实;读的一边是建置程式产生的页面,管好不好读。每一页都有一枚验证标章,措辞由一张对照表依资料里的「查证状态」栏决定:状态为「完成」,就印「已核 · 跨模型双查 ✓」。
决策点:2026-08-06,准备管理学的一个书架(12 个节点)时,我们逐节点回查查证纪录,发现两个节点的状态栏都是「完成」,实情却撑不起那句措辞。一个节点的查证承袭自另一个概念,本节点没有另跑一轮;另一个节点的核心内容经两个模型交叉查证,后来增补的一段只经一个模型查证。对照表会把两页都印成跨模型双查,而建置程式的防护只读状态栏,不会报任何错。
当时可行的做法至少有四种:一,在这两页手写标章,盖过派生值;二,改对照表,让「完成」一律印较弱的措辞;三,把两个节点的状态栏改成较低的等级;四,在内容资料加一个明示的「查证方法」栏,标章优先读它。
我们的做法与结果:我们选了第四种。这个栏位在另一个书架建置时已加入建置程式,当时已有 33 个节点在用;我们把它逐一补到这 12 个节点,9 个填跨模型,其余 3 个填较低的一级,这两个节点在内,宁可低报。状态栏照抄上游的查证纪录,本站不改;手写标章则有日后与资料分叉的风险。出图核对,这 3 个节点的标章都印成较弱的「已核 · 多源交叉 ✓」。此后标章措辞又两度收窄,现行页面改标查证深度的下限(书目、摘要或全文)。
带走:若投影规则从一个汇总等级推断措辞,而同一个等级底下其实混着不同情形,给写入的一边加一个明示栏位,让投影读事实;不在输出页上手改。
什么时候该分两个模型,什么时候不该
2026 年 8 月底,本站英文页的案例区一律显示中文:案例整块被划在事实层,英文稿不得改写事实层。把英文措辞放进去的做法至少有四种,差别在于哪些东西交给英文稿、哪些留在原件;同一个取舍,我们在简体版与协调看板上各做过一次。
此案例为 Trigpoint Pass 内容 · 含可套用判准
解锁全部实测案例 Trigpoint Pass ▸
- 常见转述「这个模式就是事件溯源的一部分」:两者是两个概念,命令查询职责分离可以配一般的资料存取方式,不必先改成事件溯源。两份原始来源都把两者分开介绍:Young 2010 年的文件说两者结合时最有意思、彼此相辅,Fowler 2011 年的文章说它与事件式的程式模型很相配;两份都没有说必须同用。 #
- 常见转述「分离就要用两个资料库、接受最终一致」:最小形态只需要两个模型,不强制两套储存。把分库的最终一致性当成必选,是把可选的放大当成定义。 #
- 常见转述「这是那位实务者 2010 年发明的」:本站把 Young 2010 年 11 月的文件标为系统化整理,不是起点。架构层的读写分离 2008 年已有文章写过,这个缩写 2009 年 12 月已在公开文章中通篇使用;命令与查询这组词汇则来自 Meyer 1988 年的《Object-Oriented Software Construction》。主张只局部施用的,是 Fowler 2011 年 7 月的文章,本站也把它标为把这个模式带入主流架构论述的一篇。发明、定名、词汇来源与推广要分开记。 #
记录核查深度,不担保结论为真。
修正记录- 首讲年份:先前版本并列的两处当事人自述(2006 与 2007 年)未能从原话核对,已改为不写年份。
如何阅读来源注记 「书目经…核对」指作者、年份、题名与出版项已确认;不代表该来源的主张已被核对。「对照全文核实」指主张已与来源文本本身比对。「依多源一致转述」指主张建立于多份彼此一致、转述该来源的资料,而非原文件本身。 定义版本:2026-09-20。
新书架开架时通知我
开架通知只在新书架开架或阅读规则变更时寄出。