本页由繁体中文版自动转换
编码与压缩
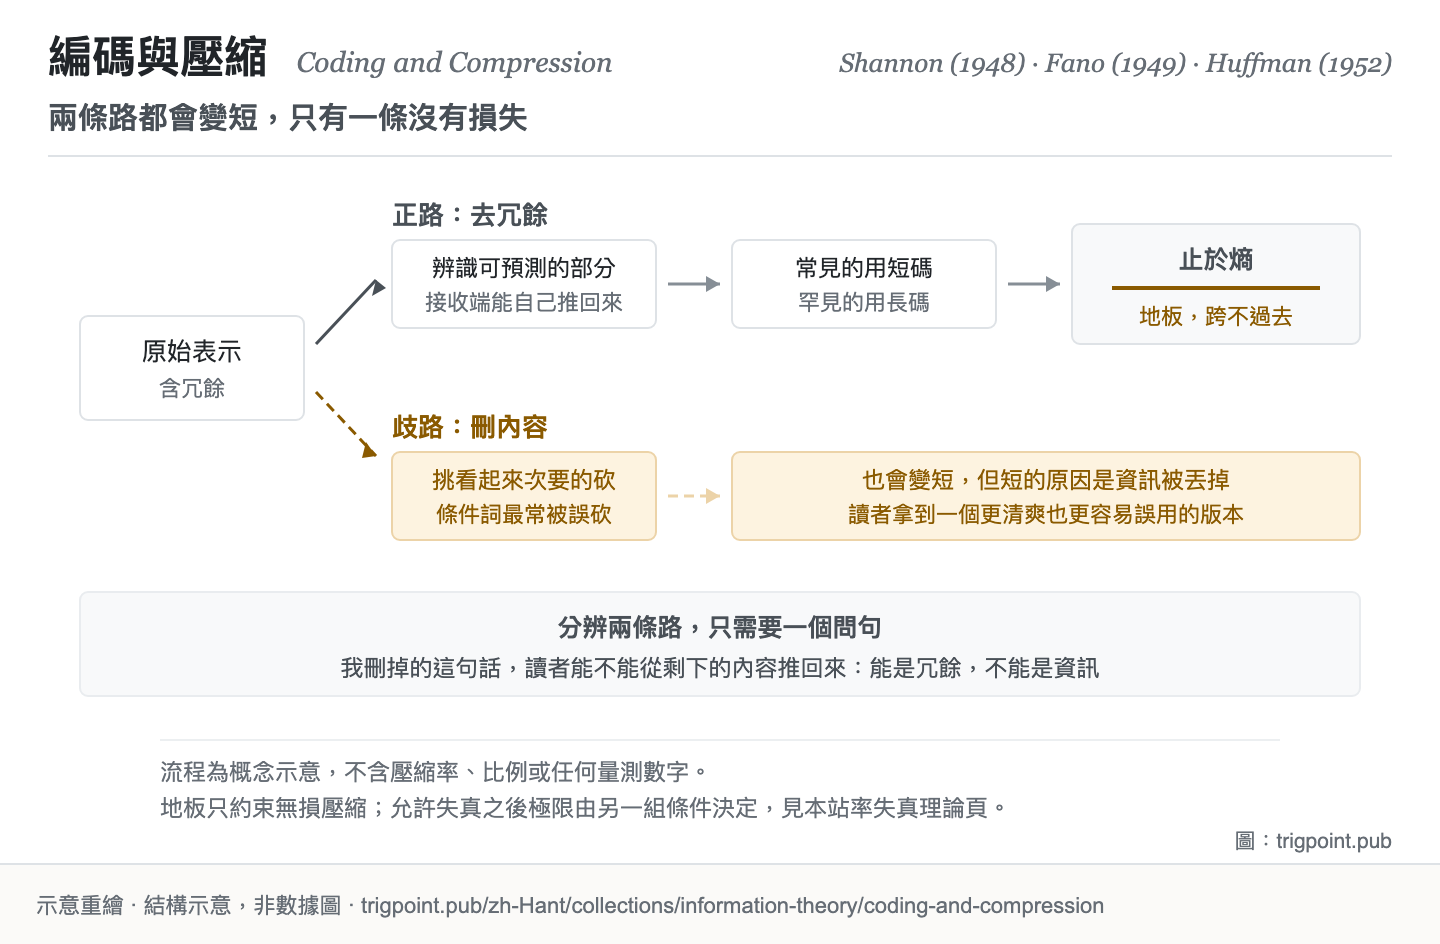
可压缩的部分叫冗余,也就是接收端本来就能推得出来的那些;把它们拿掉不损失任何东西。
而这件事有一道地板:无损压缩的平均长度不可能低于熵。
一、发生什么事
先分清楚两个常被混用的词。编码是把内容转成某种符号系统,本身不必然变短;压缩是编码的一种优化目标,利用内容里的规律,把可预测的部分用更短的方式表示。关键在可预测:一段接收端本来就猜得到的内容,用长篇幅去写是纯粹的浪费,这个浪费就叫冗余。
由此推出一条分配原则:常出现的东西用短码,罕见的东西用长码。这条原则的两个经典实作分别在 1949 与 1952 年出现。前者是由上而下的启发式作法,后者证明了由下而上的建构能保证平均码长最小[2]Fano, R. M. (1949). The Transmission of Information (Technical Report No. 65). Research Laboratory of Electronics, Massachusetts Institute of Technology. 书目经出版社记录核对。主张已对照全文核实。Shannon-Fano 编码法的发表处:把讯息依机率排序后,反复切成机率尽量相等的两组。[3]Huffman, D. A. (1952). A Method for the Construction of Minimum-Redundancy Codes. Proceedings of the IRE, 40(9), 1098–1101. DOI 10.1109/JRPROC.1952.273898. 书目经官方记录核对。要旨与摘要一致。由下而上的最优前缀码建构法,保证最小平均码长。。两者的差别不只是效率,是保证:一个是「通常不错」,一个是「可证明最优」。
而无论用什么方法,都有一道跨不过去的线。Shannon 1948 年论文的定理 9 给出无损压缩的平均码长下界,那个下界就是熵[1]Shannon, C. E. (1948). A Mathematical Theory of Communication. Bell System Technical Journal, 27(3), 379–423; 27(4), 623–656. 书目经官方记录核对。主张已对照全文核实。出处经跨模型双查核实。第 9 节(无噪音通道的基本定理)之定理 9:来源的熵决定经无噪音通道传送所需的最低平均速率,可任意逼近,不可超越;这就是无损压缩的平均码长下界。。这条线有两个实务含意,都值得记住。其一,压缩能力的上限由资料本身的机率结构决定,不由你的技术决定;其二,当你逼近那条线,继续压下去的每一步都不再是去冗余,而是在丢资讯。
无损与有损由此分岔。无损要求完整还原,受熵的地板约束;有损允许失真以换取更低的长度,它有另一套完全不同的理论极限,是「率失真理论」的主题。
二、为什么这对你重要
多数人做摘要时做的是删减,而不是压缩。两者的差别可以用一个问题分开:我删掉的这句话,读者能不能从剩下的内容推回来。能,那是冗余,删得对;不能,那是资讯,你只是把文件变短了。
这个判准会立刻改变你怎么写交接与说明。真正该砍的往往不是细节,而是那些读者的既有知识已经涵盖的铺陈:背景介绍、通则覆述、前提重申。而最不该砍的常常长得像可以砍的,也就是那些带着条件的句子。「除非」「取决于」「只有在」「必须」这类词承载的是因果与边界,它们不能从其他句子推回来,砍掉之后读者会得到一个看起来更清爽、但实际上更容易误用的版本。这件事在「率失真理论」有更精确的说法。
第二个推论是关于「解码端」。压缩的前提是双方共用同一套规律;如果接收端没有那套规律,你的短码对他就是密码。所以同一份内容给不同对象要用不同的压缩率,这不是体贴,是这套理论的直接后果。给熟手的简报和给新人的说明不能共用一份,不是因为新人需要更多资讯,是因为他们少了让你的压缩成立的那本码表。
第三个推论最反直觉:压不下去有时候是好消息。它意味着你手上的材料里冗余已经不多,剩下的都是不能推导出来的部分。这时候该做的是承认长度,不是继续削。
Lab 实测 本理论在我们工作室的两次实测
删掉重复之前,先逐条确认它真的推得回来
情境:我们的知识库有两条处理压缩的规矩。一是引用而非重写:同一个事实只写在一处,其他需要它的地方一律连过去。二是三层密度:同一份内容同时带一行摘要、三秒摘要与展开的主线,三者是同一份内容的三种粒度,不是三份副本。
2026-08-16,主理人提出知识库应该把解说与教学分开维护,我们先逐档读过内文,看类型究竟混在哪里。知识节点不拆:三层密度已在同一份内容里分出「查一下」与「读懂它」两种读法,751 个节点维持原样。真正混写的是描述工作程序的文件,其中一份的顶部逐版写着改版说明,与同一档档尾的版本纪录表重复。
决策点:要清掉这段重复,当时可行的做法至少有四种。一,直接删掉顶部的逐版说明。二,删掉档尾的版本纪录表,只留顶部。三,两处都留,另加一条要求两处同步的规则。四,先逐条核对顶部每一段在表里是否有对应,再把顶部压成一行指向表的连结。
我们的做法与结果:我们选了第四种。盘点报告写顶部有 15 段,实数是 12 段逐版说明,加一行基底版本的描述。逐条核对时发现,当时正在使用的那一版在表里没有任何一列,它的版本史只存在于顶部;照「删除重复」直接删,会删掉这一版唯一的纪录。
我们先在表里补上这一列,再把顶部压成一行连结;顶部以下的 10 段规则说明,以脚本逐段确认保留。连结那一行同时写明:此后每次改版只写表列。截至 10-25,这份文件又改版多次,顶部没有再长出逐版说明,版本史已另移到同一资料夹的独立档案。
带走:若要删掉一段看起来重复的内容,先逐条确认每一部分都能从留下来的内容推回来;推得回来的是冗余,推不回来的是资讯,要先搬过去再删。
双记的帐单:角色表写在几处,职称改了,旧的那份照样被读
2026 年 4 月,我们的角色表同时写在几份文件里。一次新增角色,改动要分头写进三处;两天后,两份角色表已经对不上。这时可行的处置至少有四种,差别在于下一次改动要记得改几个地方,以及漏改的那一份会不会被当真。
此案例为 Trigpoint Pass 内容 · 含可套用判准
解锁全部实测案例 Trigpoint Pass ▸
如何阅读来源注记 「书目经…核对」指作者、年份、题名与出版项已确认;不代表该来源的主张已被核对。「与摘要一致」指主张与论文摘要相符;不含逐句对照全文。「对照全文核实」指主张已与来源文本本身比对。 定义版本:2026-09-20。
- [1] Shannon, C. E. (1948). A Mathematical Theory of Communication. Bell System Technical Journal, 27(3), 379–423; 27(4), 623–656. ↩
- [2] Fano, R. M. (1949). The Transmission of Information. MIT RLE Technical Report No. 65. ↩
- [3] Huffman, D. A. (1952). A Method for the Construction of Minimum-Redundancy Codes. Proceedings of the IRE, 40(9), 1098–1101. ↩
新书架开架时通知我
开架通知只在新书架开架或阅读规则变更时寄出。