本页由繁体中文版自动转换
演算法资讯观
这条路不需要机率,因此可以对单一对象发问,而 Shannon 的熵不能。
代价是这个量不可计算,只能从上方逼近。
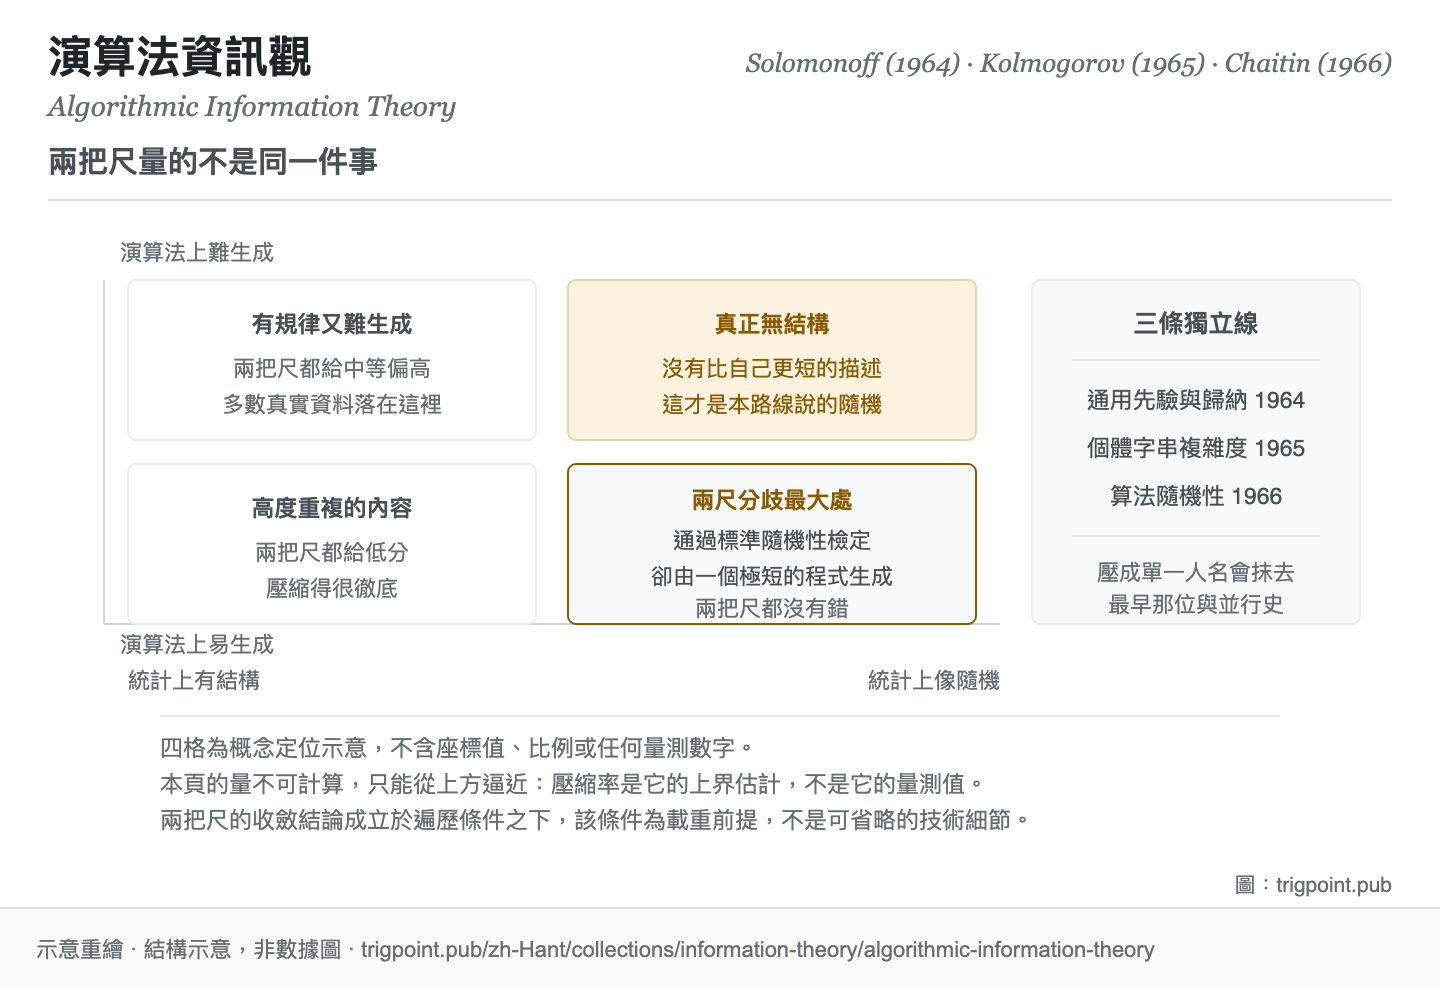
右下格是两把尺分歧最大的地方,一段通过标准随机性检定的数字,可能由一个极短的程式产生。 放大看图 ▸转发 PNG ▸
一、发生什么事
平均而言有多难猜,和单独这一份有多难描述,是两个不同的问题:前一个需要机率,后一个不需要。Shannon 的熵有一个前提:你得先有一个机率分布。这对「一批资料平均而言」是自然的,但对「这一份文件」就无话可说了,因为单一对象没有分布。1960 年代有三个人各自独立想到同一个出路:不谈机率,谈描述[1]Solomonoff, R. J. (1964). A Formal Theory of Inductive Inference, Part I. Information and Control, 7(1), 1–22; Part II, 7(2), 224–254. 书目经官方记录核对。通用先验与归纳推理的算法基础,分两部分刊出;三条独立线中发表最早。[2]Kolmogorov, A. N. (1965). Three Approaches to the Quantitative Definition of Information. Problems of Information Transmission, 1(1), 1–7. 书目经双源核对。个体字串复杂度之形式定义;此处页码为英译本。[3]Chaitin, G. J. (1966). On the Length of Programs for Computing Finite Binary Sequences. Journal of the ACM, 13(4), 547–569. DOI 10.1145/321356.321363. 书目经官方记录核对。算法随机性理论之第三条独立线。。一段东西的资讯量,等于在一台通用计算机上能把它生成出来的最短程式有多长。
这个定义有几个立刻可用的性质。第一,它几乎不依赖机器的选择:换一台通用计算机,这个量的变化不超过一个固定的常数。第二,它给了「随机」一个干净的定义:一段东西是随机的,当且仅当没有比它自己更短的描述,也就是完全无法压缩。第三,也是代价:这个量不可计算,不存在通用的演算法能算出它,这是停机问题的推论。实务上只能从上方逼近,任何压缩演算法的输出长度都是它的一个上界。
两条路线在什么时候会分歧,是这一页最值得记的东西。对纯随机的来源,两者的期望值会收敛;但对演算法上有结构的对象,它们会严重分歧。经典例子是一个无理数的前一百万位:它通过标准的随机性检定,因此在 Shannon 的尺下不确定性极大、几乎不可压缩;但它可以由一个很短的程式生成,因此在这把尺下复杂度极小。同一段东西,两把尺给出相反的答案,而两把尺都没有错,它们量的本来就是不同的东西。
两者的桥梁见于 1982 年刊出的一篇论文:对遍历的不变测度,动力系统的熵几乎处处等于单位时间的算法复杂度[4]Brudno, A. A. (1982/1983). Entropy and the Complexity of the Trajectories of a Dynamical System. Trudy Moskovskogo Matematicheskogo Obshchestva, 44, 124–149; English translation in Transactions of the Moscow Mathematical Society, (2), 127–151. 书目经官方记录核对。出处经跨模型双查核实。对遍历的不变测度,Kolmogorov-Sinai 熵几乎处处等于轨道单位时间的算法复杂度。遍历性为载重条件,不是可省略的技术细节;White(1993)推广了这个结果。英文本为 1983 年之译本。。这个结果有一件容易被略过的事:遍历性是载重条件,不是可省略的技术细节;1993 年另有推广。
至于实务化,Rissanen(1978)把「选最短总描述」变成可操作的模型选择准则:把模型本身的描述长度与资料在该模型下的编码长度加起来,选总和最小的[5]Rissanen, J. (1978). Modeling by Shortest Data Description. Automatica, 14(5), 465–471. DOI 10.1016/0005-1098(78)90005-5. 书目经官方记录核对。最小描述长度原理的起点,将本路线实务化为模型选择准则。。
二、为什么这对你重要
这一页把一个常被当作品味的东西,升格成有形式基础的判准:简洁不是美学偏好,是可以定义的。
日常里我们说一个解释「比较简洁」,通常没有办法辩护,因为简洁看起来是主观的。这套理论给的说法是:一个解释的成本,等于描述这个解释本身的长度,加上在这个解释之下描述现象所需的长度。两者要一起算。这立刻解释了两种常见的失败。一种是规则太少:解释本身很短,但每个个案都要另外交代,总长度反而更大。另一种是规则太多:每个个案都有专属条款,资料端几乎不用描述,但规则本身长得惊人。两者都输给中间那个总和最小的版本。
这条原则我们自己在用,而且用在一个具体的地方:治理面的规则要不要再加一条。判准不是「这条规则有没有用」,而是「加上它之后,规则本身的长度与它省下的个案描述,哪一边多」。多数提案在这个算法下会被否决,因为它们节省的是一两个个案,付出的是每个人此后都要记住的一条规则。
第二件事是对「随机」的祛魅。看起来很乱不等于资讯量大,这在判读资料时很有用:一段杂讯般的输出,可能来自一个极简单的机制;反过来,一段看起来井然有序的内容,也可能需要很长的描述才能重建。表面的规律性与生成的复杂度是两回事,而多数人只看得到前者。
第三是一个界线:不要拿压缩率当作复杂度的量测值。压缩率是上界的估计,两者不是同一个东西,这个越界在资料分析里相当常见。
Lab 实测 有实测才写
本节点暂无实测。
如何阅读来源注记 「书目经…核对」指作者、年份、题名与出版项已确认;不代表该来源的主张已被核对。 定义版本:2026-09-20。
- [1] Solomonoff, R. J. (1964). A Formal Theory of Inductive Inference, Part I. Information and Control, 7(1), 1–22; Part II, 7(2), 224–254. ↩
- [2] Kolmogorov, A. N. (1965). Three Approaches to the Quantitative Definition of Information. Problems of Information Transmission, 1(1), 1–7. ↩
- [3] Chaitin, G. J. (1966). On the Length of Programs for Computing Finite Binary Sequences. Journal of the ACM, 13(4), 547–569. ↩
- [4] Brudno, A. A. (1982/1983). Entropy and the Complexity of the Trajectories of a Dynamical System. Trudy Moskovskogo Matematicheskogo Obshchestva, 44, 124–149; Transactions of the Moscow Mathematical Society, (2), 127–151. ↩
- [5] Rissanen, J. (1978). Modeling by Shortest Data Description. Automatica, 14(5), 465–471. ↩
新书架开架时通知我
开架通知只在新书架开架或阅读规则变更时寄出。