檢索增強生成
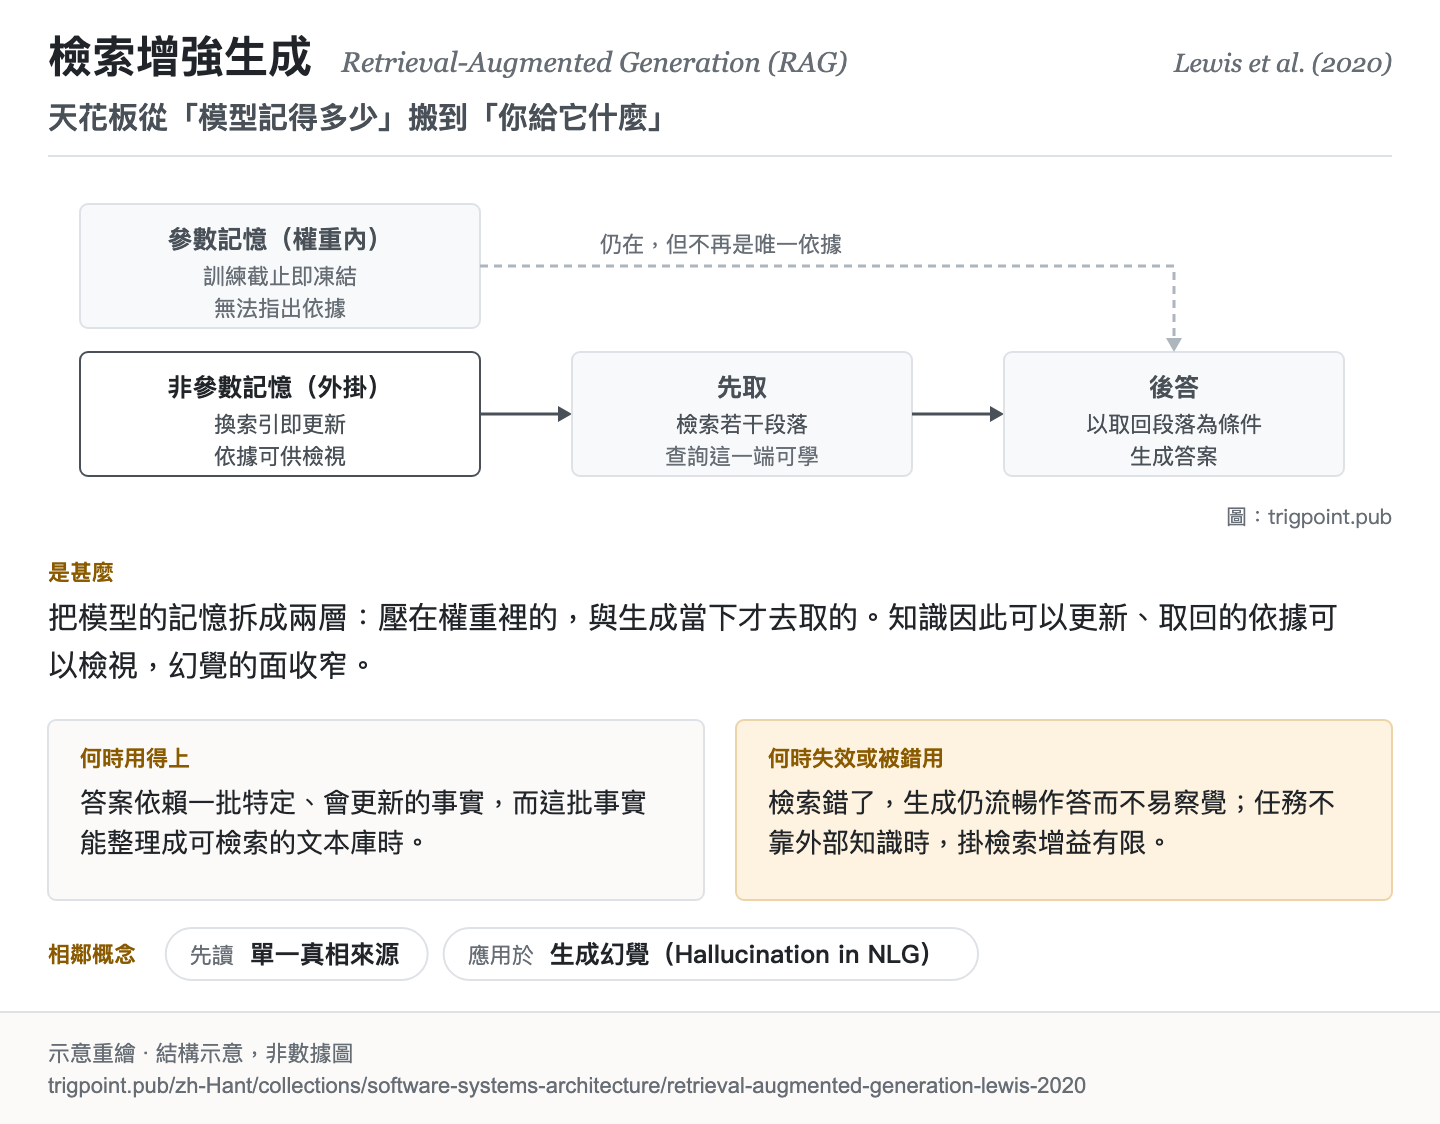
知識因此可以更新、取回的依據可以檢視,幻覺的面收窄。
但品質的天花板也跟著搬家:從模型記得多少,變成你的檢索庫有多好。
- 成立條件
- 答案依賴一批特定、會更新的事實,而這批事實能整理成可檢索的文本庫時。
- 證據強度
- 概念框架;摘要已核
- 失效樣貌
- 檢索錯了,生成仍流暢作答而不易察覺;任務不靠外部知識時,掛檢索增益有限。
權重裡那一層仍在,但不再是作答的唯一依據。
生成時先取後答。
流程為概念示意,不含任何效果數值。 放大看圖 ▸轉發 PNG ▸
一、發生什麼事
在論文報告的一組開放領域問答中,就算取回的段落都沒有答案,模型還是答對了一成多。純參數的生成模型把知識封在權重裡,這帶來三個結構性弱點:知識過期(訓練截止就凍結)、不可溯源(無法指出答案的依據)、以及在分佈外仍然高信度地生成。
這篇 2020 年的論文的做法是把記憶分兩層:參數記憶(權重)之外,再掛一層非參數記憶,一個生成當下才去檢索的外部文本庫[1]Lewis, P., Perez, E., Piktus, A., Petroni, F., Karpukhin, V., Goyal, N., Küttler, H., Lewis, M., Yih, W., Rocktäschel, T., Riedel, S., & Kiela, D. (2020). Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. arXiv:2005.11401. 書目經官方記錄核對。主張已對照全文核實。預印本第一版 2020-05-22,共 12 位作者。摘要把這套做法描述為結合參數化與非參數化記憶的語言生成;摘要把「為決策標示出處」列為純參數模型的未解問題,並以此作為接上外部記憶的理由。原始設計中檢索器與生成器一起訓練,但文件編碼器與索引固定,只微調查詢端與生成器(該篇 §2.4)。。流程是先取後答:把問題轉成檢索,取回若干段落,再讓生成以那些段落為條件作答。原始設計裡檢索器與生成器一起訓練:文件那一端的編碼與索引固定不動,問題那一端的編碼與生成器一起微調。所以檢索這一步有一部分是可學的,不只是外掛。
三個弱點因此各有處置:知識更新變成換索引而不必重訓;取回的段落可以拿出來檢視(論文把「標示出處」列為純參數模型的未解問題,並以此作為接上外部記憶的理由;原模型並不輸出引用);生成的分佈被外部證據收窄。
但上限也要講清楚[4]邊界:檢索錯時生成多半受拖累,屬推論,不是論文的結論;該篇 §4.1 另報告,在一組開放領域問答上,答案不在任何取回文件時仍有 11.8% 答對,參數記憶可補位。引用在場不等於引用被正確使用,亦屬推論(原模型不輸出引用)。對無需外部知識的任務增益有限,出自該篇附錄 H 的初步觀察,其原因原文屬推測。:檢索層自己弱的話,生成多半會被拖累。 不是必然照錯:論文報告過,在一組開放領域問答上,答案不在任何取回段落時仍有一成多答對,權重裡那一層會補位。所以品質的天花板從「模型記得多少」搬到「檢索庫有多好、檢索器準不準」。這不是消滅了知識問題,是把它外部化:而外部化的好處是它變得可以被治理(你能檢查、能更新、能指定範圍),不是它消失了。
二、為什麼這對你重要
你大概已經在用這個模式,而且用的是它最弱的形態。
把檔案丟給模型、讓它讀完再回答,那就是檢索增強的手工版。它有效,而它的效力完全取決於你丟了什麼進去。這頁要你把注意力從「怎麼問」移到「取什麼給它」,因為後者才是天花板。
三件事直接可用。
第一,先建可信的那一層,再談問法。 大部分人花力氣調整問法,而問法能改善的是表達,不是依據。如果你要它回答的東西依賴一批特定的事實,那批事實得先存在、被整理過、而且你知道它們對。
第二,引用在場不等於引用被正確使用。 這是本頁最實用的一句。模型可以附上一份真實存在的來源,同時說出那份來源沒有說的話。查核的動作不是「有沒有附出處」,是「這句話是不是那份出處說的」。
第三,這個做法對不需要外部知識的任務增益有限[4]邊界:檢索錯時生成多半受拖累,屬推論,不是論文的結論;該篇 §4.1 另報告,在一組開放領域問答上,答案不在任何取回文件時仍有 11.8% 答對,參數記憶可補位。引用在場不等於引用被正確使用,亦屬推論(原模型不輸出引用)。對無需外部知識的任務增益有限,出自該篇附錄 H 的初步觀察,其原因原文屬推測。。純推理、風格改寫、結構重排這類任務,掛檢索未必有幫助,還可能引入無關內容。判斷方法很簡單:這個任務答錯的時候,是因為它不知道某件事,還是因為它想錯了。前者掛檢索有用,後者沒用。
Lab 實測 有實測才寫
本節點暫無實測。
- 常見轉述「接了檢索就不會產生幻覺」:檢索錯了,生成多半會被拖累,而且答得流暢。這個做法把知識問題外部化,不消滅它。品質的瓶頸有相當部分移到檢索庫與檢索器。 #
- 常見轉述「有引用就代表有根據」:引用在場不等於引用被正確使用。答案可以附一份真實的來源,同時說出那份來源沒有說的話。 #
- 常見轉述「檢索增強生成由這篇首創」:這篇一般被視為術語的出處,但先行者之一是 2020 年 2 月另一篇把檢索增強放在預訓練階段的論文,早它三個月;這篇自己的引言也把那篇與一篇 2019 年的檢索式問答模型並列。 #
記錄核查深度,不擔保結論為真。
修正記錄- 本站對這篇的會議收錄標為次級:該資訊來自預印本頁面的自述附註,非會議官方紀錄。先行者之一(Guu 等人 2020 年 2 月的論文)的會議收錄在其預印本頁未顯示,本站不 claim。
- 2026-10-12 · 本頁前版有三處超出原論文,已依全文改正。其一,前版說檢索錯了生成就會照著錯答;論文 §4.1 報告答案不在任何取回文件時仍有 11.8% 答對,改為「多半受拖累」。其二,前版說答案可以附出處;原模型並不輸出引用,論文說的是取回的知識可以檢視,故改為取回段落可供檢視。其三,前版說檢索器與生成器一起微調;原設計中文件編碼器與索引固定,只微調查詢端與生成器。另,「對不需外部知識的任務增益有限甚至為負」改為論文附錄的初步觀察,刪去「甚至為負」。
如何閱讀來源註記 「書目經…核對」指作者、年份、題名與出版項已確認;不代表該來源的主張已被核對。「對照全文核實」指主張已與來源文本本身比對。 定義版本:2026-09-20。
- [1] Lewis, P. et al. (2020). Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. arXiv:2005.11401.
- [4] 編輯註,無外部來源;全文見正文註 [4]。
新書架開架時通知我
開架通知只在新書架開架或閱讀規則變更時寄出。