資訊量
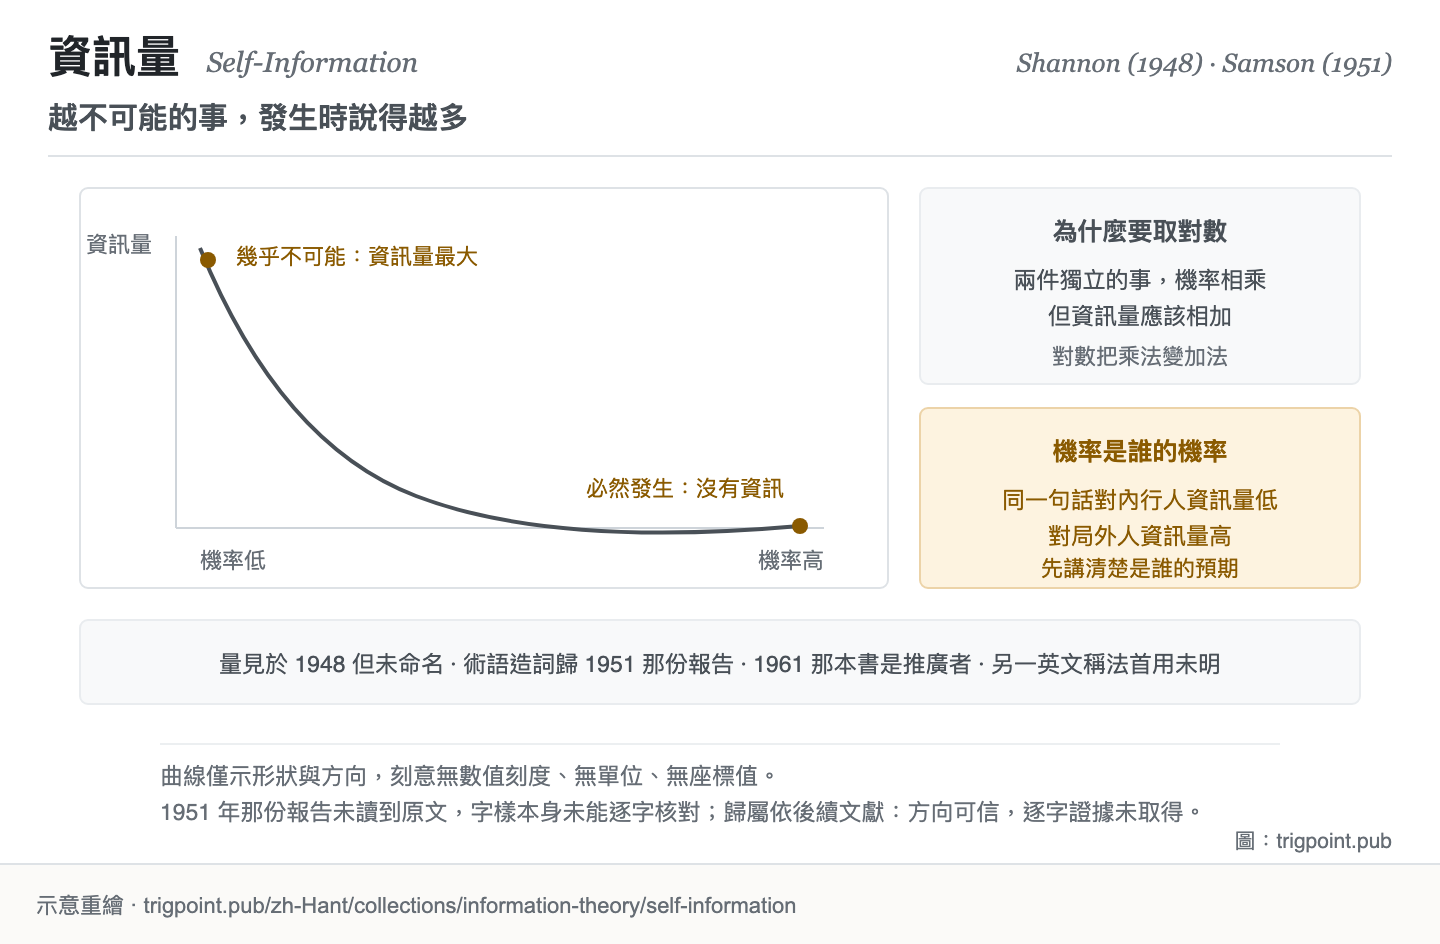
必然發生的事發生了,等於什麼也沒告訴你;幾乎不可能的事發生了,帶的資訊量最大。
所以資訊量量的是它推翻了多少你原本的預期。
右側說明為何要取對數,兩個獨立事件的資訊量才加得起來。
本圖刻意無數值刻度與單位。 放大看圖 ▸轉發 PNG ▸
一、發生什麼事
替一個事件算資訊量之前,要先做一個選擇:用掌握內情者的機率,還是局外人的機率。把資訊定義為不確定性的削減之後,下一步是替單一事件定出一個數。答案其實已經藏在 Shannon 1948 年的論文裡:熵是每個結果的 log(1/p) 按機率加權的平均,論文也用同一個量界定單一訊息所需的碼長[1]Shannon, C. E. (1948). A Mathematical Theory of Communication. Bell System Technical Journal, 27(3), 379–423; 27(4), 623–656. DOI 10.1002/j.1538-7305.1948.tb01338.x. 書目經官方記錄核對。主張已對照全文核實。論文用到這個量:熵是各結果的 log(1/p) 按機率加權的平均,單一訊息所需碼長的界也以 log(1/p) 表示。但論文沒有把它單獨定義為單一事件的資訊量,也沒有替它命名;全文不見 self-information、surprisal、mutual information 這幾個詞。。把它單獨拿出來看,結論簡潔到有點反直覺:一個事件的資訊量,只由它的機率決定,機率越低資訊量越高。必然發生的事,資訊量為零。
為什麼要取對數,而不是直接用機率的倒數?因為要讓資訊量加得起來。兩件互不相干的事同時發生,它們合起來帶的資訊,直覺上應該是各自資訊量的和;而兩件獨立事件同時發生的機率是兩個機率相乘。要把乘法變成加法,對數是唯一自然的選擇。這個看似技術性的決定,讓資訊變成一個可以累計、可以比較、可以當單位用的量,整套理論的實用性都建立在這上面。
這裡有個容易滑過去的細節:機率是誰的機率。同一件事,對掌握內情的人機率高、資訊量低,對局外人機率低、資訊量高。理論本身不規定機率從哪裡來,它只要求你先講清楚是誰的預期。這就是為什麼「這句話資訊量大不大」沒有絕對答案,只有「對誰」的答案。
至於名字,有兩件事要分開記。這個量出自 Shannon 1948 年論文的框架,但論文沒有替它命名[1]Shannon, C. E. (1948). A Mathematical Theory of Communication. Bell System Technical Journal, 27(3), 379–423; 27(4), 623–656. DOI 10.1002/j.1538-7305.1948.tb01338.x. 書目經官方記錄核對。主張已對照全文核實。論文用到這個量:熵是各結果的 log(1/p) 按機率加權的平均,單一訊息所需碼長的界也以 log(1/p) 表示。但論文沒有把它單獨定義為單一事件的資訊量,也沒有替它命名;全文不見 self-information、surprisal、mutual information 這幾個詞。;「surprisal」這個詞的造詞優先權,後續文獻歸於 1951 年一份空軍研究報告,Tribus 1961 年的書使它流通但非首創[2]Samson, E. W. (1951). Fundamental Natural Concepts of Information Theory. AFCRC Report E5079. 書目經雙源核對。「surprisal」一詞之造詞歸屬依多源一致轉述。後續文獻把「surprisal」一詞的造詞優先權歸於本報告。本站未讀到報告原文,該詞是否出現在報告內未能逐字核對。[3]Tribus, M. (1961). Thermostatics and Thermodynamics. Van Nostrand. 書目經雙源核對。本書推廣該詞之說依多源一致轉述。使「surprisal」一詞流通,屬推廣而非首創。;而英文裡另一個常見稱法不見於 1948 年那篇,不宜歸給任何一位[4]「self-information」一詞不見於 Shannon 1948 年的論文;本站未查到可靠的首用出處,故不歸給任何一位。。
二、為什麼這對你重要
這一頁給你的是一個可以直接套用的閱讀動作:讀任何一段內容,先問它推翻了你哪一項預期。
這個動作能立刻分辨兩種讀起來很像的東西。一種是把你已經相信的事,用更完整、更有條理的方式重講一遍;另一種是告訴你某件你以為如此的事其實不然。前者讀起來很舒服,資訊量接近零;後者讀起來不舒服,資訊量高。舒適感與資訊量在這裡是負相關的,這對挑選閱讀材料是一條很鋒利的判準。
用在模型輸出上更直接。一份回應如果完全落在你的預期分佈裡,無論它多長多完整,它對你的不確定性沒有削減。真正有用的輸出通常有一個共同特徵:其中至少有一項是你事前會賭它不是這樣的。所以與其問「這個回答好不好」,不如問「它有沒有任何一處讓我意外」。沒有,那這次呼叫的產出接近零,不管它產生了多少字。
反過來也成立,而且這是一個實用的自我檢查:當你寫的東西讓所有人都點頭,你可能什麼也沒說。共識性的陳述機率高、資訊量低。這不代表它們沒有價值,鋪陳與對齊有它們的功能,但要清楚那部分不是你在傳遞資訊,是你在對齊機率分佈。兩件事要分開計。
Lab 實測 有實測才寫
本節點暫無實測。
如何閱讀來源註記 「書目經…核對」指作者、年份、題名與出版項已確認;不代表該來源的主張已被核對。「對照全文核實」指主張已與來源文本本身比對。「依多源一致轉述」指主張建立於多份彼此一致、轉述該來源的資料,而非原文件本身。 定義版本:2026-09-20。
- [1] Shannon, C. E. (1948). A Mathematical Theory of Communication. Bell System Technical Journal, 27(3), 379–423; 27(4), 623–656. ↩
- [2] Samson, E. W. (1951). Fundamental Natural Concepts of Information Theory. AFCRC Report E5079. ↩
- [3] Tribus, M. (1961). Thermostatics and Thermodynamics. Van Nostrand. ↩
- [4] 編輯註,無外部來源;全文見正文註 [4]。
新書架開架時通知我
開架通知只在新書架開架或閱讀規則變更時寄出。